第二章 流的起源
本书探讨的是如何利用流处理工具构建业务系统,因此,了解流处理技术的起源将大有裨益。在实时分析领域,这套工具体系的日趋成熟,深刻影响了我们当今构建事件驱动系统的方式。
图 2-1 展示了一个流处理系统,它用于从数十万台移动设备中采集数据。每台设备都会发送小型的 JSON 消息,记录手机上各类应用程序的开启、关闭或崩溃事件。通过这些数据,我们可以识别系统的不稳定性——即崩溃次数与使用次数之比相对较高的情况。
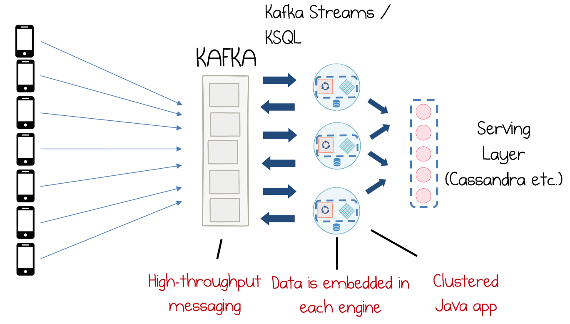
移动设备将数据发送至 Kafka,Kafka 对其进行缓冲,直至需要使用这些数据的各类应用程序将其提取出来。对于此类工作负载,集群规模通常较大;粗略估算,Kafka 的数据摄入速度可达网络带宽上限,但由于副本复制(replication)带来的开销,实际吞吐量通常会降至原来的三分之一(例如,在一个由三个节点组成的 10 GbE 集群中,实际数据摄入速率约为 1 GB/s)。
在图 2-1 中,Kafka 的右侧是流处理层。这是一个集群化应用程序,其中的查询既可以通过 Java DSL 预先定义,也可以通过 KSQL(Kafka 类 SQL 流处理语言)动态提交。与传统数据库不同,这些查询会持续进行计算;因此,每当有新数据进入流处理层时,查询便会重新计算,若查询结果发生变化,系统就会输出新的结果。
当新消息完成所有流处理计算后,结果会被存入服务层(serving layer),供后续查询使用。图 2-1 中展示的是 Cassandra,但将数据写入 HDFS(Hadoop 分布式文件系统)或其他数据存储系统,或是利用 Kafka Streams 的“交互式查询”(interactive queries)功能直接进行查询,也都是常见的做法。
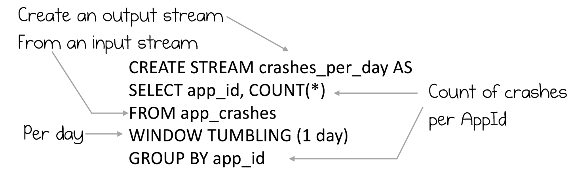
为了更好地理解流处理,我们可以参考一个典型的查询示例。图 2-2 展示了一个计算“每日应用崩溃总次数”的查询。每当有一条新消息(表示应用发生崩溃)进入时,该应用的总崩溃次数就会增加。请注意,这种计算需要维护“状态”:必须存储当天累计的崩溃次数(即在指定时间窗口内的统计值),这样即使流处理器发生崩溃或重启,统计计数也能从中断处继续累加。Kafka Streams 和 KSQL 会在内部管理这些状态,并通过“变更日志主题”(changelog topic)将状态备份至 Kafka。关于此内容的详细讨论,请参阅第 14 章(第 135 页)中的“窗口、连接、表与状态存储”(Windows, Joins, Tables, and State Stores)一节。
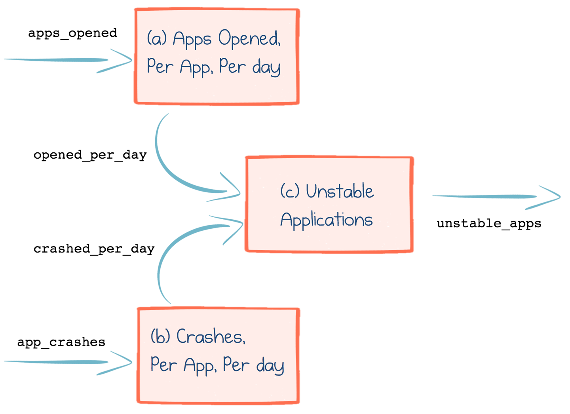
此类查询可以串联在一起,形成一个处理流水线。在图 2-3 中,我们将前述问题拆解为三个步骤,并将其串联成两个阶段。查询 (a) 和 (b) 分别持续计算每日应用打开次数与每日应用崩溃次数。这两个输出数据流在最终阶段 (c) 中进行合并;该阶段通过计算崩溃次数与使用次数之间的比率,并将其与设定的阈值进行比较,从而得出应用的稳定性指标。
关于这种流处理方式,还有几点需要注意:
流处理层具备容错能力
它以集群形式运行在所有可用节点上。如果某个节点退出,其他节点会接手并从中断处继续处理。同样,你也可以通过添加新的处理节点来横向扩展集群。工作负载及所需的任何状态都会自动重新分配,以充分利用这些新增资源。
每个流处理节点都可以维护自身的状态
这对于数据缓冲以及存储完整表(例如用于数据丰富操作)至关重要(关于流和表的详细讨论,请参阅第 14 章第 135 页的“窗口、连接、表与状态存储”一节)。这种本地存储机制非常重要,它使流处理器能够执行快速的“逐条消息”查询,而无需经过网络——对于互联网规模应用中常见的高吞吐量工作负载而言,这是一项必要特性。此外,这种在本地存储中维护状态的能力,在许多业务场景中也非常有用,我们将在本书后续章节中进行探讨。
每个流处理器都可以写入并存储本地状态
在处理高吞吐量事件流时,针对每条消息都发起网络调用显然不是明智之举。因此,流处理器会将数据写入本地(从而实现快速读写),并将这些写入操作备份到 Kafka。例如,前文提到的计数操作需要跟踪一个累计总数;这样,即使发生崩溃并重启,计算过程也能从中断点恢复,确保计数值依然准确。这种在本地存储数据的能力,在概念上与传统应用程序中与数据库交互的方式非常相似。但与传统两层架构(其中与数据库交互通常意味着发起网络调用)不同,在流处理中,所有状态都保存在本地(可以将其视为一种缓存),因此访问速度极快,无需任何网络调用。同时,由于数据会同步回写到 Kafka,它也继承了 Kafka 所提供的持久性保证。我们在第 15 章(第 142 页)的“在流处理系统中扩展并发操作”一节中对此进行了更详细的讨论。