第七章 事件溯源、CQRS 和其他有状态模式
在第 5 章中,我们介绍了“事件协作”(Event Collaboration)模式。在这种模式下,事件用于描述不断演进的业务流程——例如处理在线购物,或是预订并结算一笔交易——多个服务通过协作来推动这一工作流程向前发展。
由此产生了一份记录系统所有状态变更的日志,且这些记录以不可变(immutable)的方式保存。这进而引出了两种相关的模式——“命令查询职责分离”(Command Query Responsibility Segregation,简称 CQRS)和“事件溯源”(Event Sourcing)1 ——它们旨在帮助系统实现扩展,并降低数据损坏的风险。本章将探讨这些概念的含义、实现方式以及适用场景。
事件溯源(Event Sourcing)、命令溯源(Command Sourcing)与 CQRS 概览
从宏观层面来看,事件溯源(Event Sourcing)的核心理念在于:事件(即状态变更)是任何系统中的核心要素。因此,如果将这些事件按照产生顺序以不可变(immutable)的方式存储下来,所形成的“事件日志”便能提供一份详尽的审计记录,准确反映系统所执行过的所有操作。此外,我们还可以通过回溯日志并按顺序重放这些事件,随时重新推导出系统的当前状态。
CQRS(命令查询职责分离)是这一理念的自然延伸。举个简单的例子:你可以将事件写入 Kafka(作为“写模型”),随后读取这些事件,并将它们存入数据库(作为“读模型”)。在此场景下,Kafka 实现了“读模型”与“写模型”之间的异步映射,在时间维度上将两者解耦,从而使这两部分能够各自进行独立优化。
命令溯源(Command Sourcing)本质上是事件溯源的一种变体,不同之处在于它所关注的是“进入”服务的事件,而非服务自身所产生的事件。
上述概念或许有些抽象,让我们结合图 7-1 中的示例来具体说明。我们将沿用前一章提到的场景:用户进行在线购物,系统对生成的订单进行验证并返回相应结果。
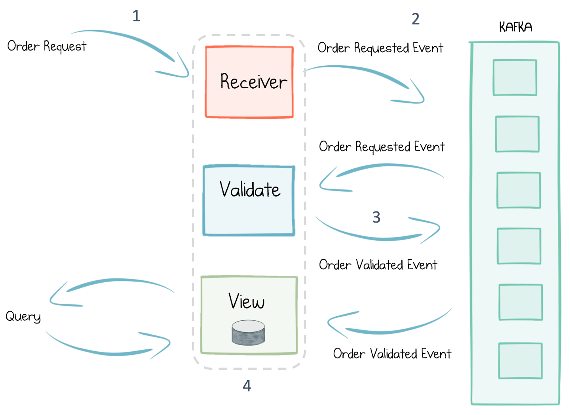
当发生购买行为时 (1),命令溯源(Command Sourcing)要求在执行任何后续操作之前,先将订单请求作为事件立即存入日志 (2)。这样,一旦出现问题,系统便可进行回溯与重放——例如,在数据损坏的情况下用于恢复数据。
接下来,系统会对订单进行验证,并将另一个事件存入日志,以反映由此产生的状态变更 (3)。与 CRUD(增、删、改、查)这类“原地更新”的持久化模型不同,经过验证的订单会以一个全新的事件形式被追加到日志中,而非覆盖原有的订单记录。这正是“事件溯源”(Event Sourcing)的核心所在。
最后,为了查询订单,系统会将一个数据库挂载到生成的事件流上,从而导出一个事件溯源视图(event-sourced view),用以呈现系统中订单的当前状态 (4)。因此,步骤 (1) 和 (4) 分别构成了 CQRS(命令查询职责分离)中的“命令”端与“查询”端。
这些模式具有诸多优势,我们将在后续章节中进行详细探讨。
数据版本控制
当你在日志中存储事件时,它在某种程度上就像是数据的一种版本控制系统。请参考图 7-2 所示的情景:如果程序中引入了缺陷(例如,将时间戳字段解析成了错误的时区),就会导致数据损坏。这种损坏不仅会波及数据库,还会扩散到该服务与其他服务之间的交互中,从而使损坏范围进一步扩大,修复起来也更加困难。
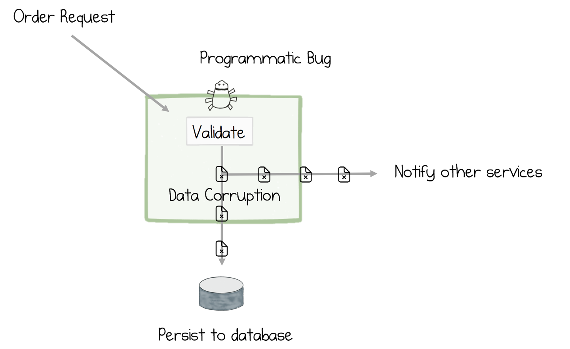
要从这种局面中恢复过来,情况会比较棘手,原因有二。首先,系统最初的输入并未被精确记录下来,因此我们手头仅存一份已损坏的订单数据;我们必须通过人工方式对其进行修复。其次,与能够“时光倒流”的版本控制系统不同,数据库中的数据是在原地(in-place)进行修改的,这意味着系统之前的状态已永久丢失。因此,该服务无法轻易撤销由数据损坏所造成的后果。
为了解决这个问题,程序员需要执行一系列操作:修复软件本身;运行数据库脚本以修正数据库中损坏的时间戳;最后,设法重新发送之前已传给其他服务但现已损坏的数据。最理想的情况是编写一段定制代码,从数据库中提取数据并进行修复,然后通过新的服务调用将修正后的数据重新分发出去。然而,由于数据库存在“有损”特性(即旧值会被新值覆盖),仅靠这种方法可能还不够。(如果系统在运行新版本一段时间后被回滚至旧版本,而非直接修复当前版本,那么数据迁移的过程可能会变得更加复杂。)
如果改用“事件溯源”(Event Sourcing)或“命令溯源”(Command Sourcing)模式——即同时记录输入内容与状态变更——其架构可能如图 7-3 所示。
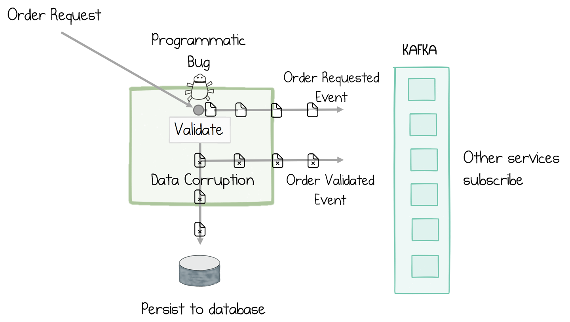
由于 Kafka 可以根据需要长期存储事件(详见第 4 章第 25 页“长期数据存储”一节),因此修复时间戳错误变得相对简单。首先修复程序中的缺陷,然后将日志回溯到缺陷引入之前的状态,并基于订单请求流对系统进行重放。数据库中的数据会被自动覆盖,更新为正确的时间戳;同时,新的事件会被发布到下游,从而修正之前那些错误的数据。这种存储输入、回溯并重放的能力,使得系统在应对数据损坏和程序缺陷时的恢复能力大大增强。
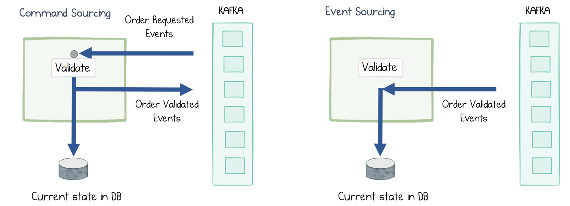
“命令溯源”(Command Sourcing)允许我们记录所有的输入,这意味着系统始终可以回溯并重放。“事件溯源”(Event Sourcing)则记录了状态的变化,确保我们能够精确掌握系统运行期间发生的一切;此外,我们还可以根据这些状态变化日志,随时重新生成当前状态(在本例中即数据库中的内容)(见图 7-4)。
能够存储一份按顺序排列的状态变更日志,对于调试和可追溯性也大有裨益。它有助于解答诸如“为什么这笔订单莫名其妙地被拒绝了?”或“为什么账户余额突然出现了负值?”这类回顾性问题——而在使用可变数据存储的情况下,回答这些问题往往要困难得多。
值得一提的是,还有其他一些成熟的数据库模式也能提供上述部分特性。例如,可以使用暂存表(staging table)来存放未经校验的输入;在许多关系型数据库中,可以利用触发器(trigger)来创建审计表;双时态数据库(bitemporal database)也能提供一种可审计的数据结构。这些都是行之有效的技术手段,但若要通过它们实现“回溯与重放”(rewind and replay)功能,程序员往往需要投入大量额外的工作。相比之下,采用“事件溯源”(Event Sourcing)方法,则几乎无需编写或测试额外的代码。同一套执行路径既可用于系统的运行时操作,也可用于数据恢复。
将事件作为“事实来源”
采用“事件溯源”(Event Sourcing)模式会带来一个显著影响:事件(而非数据库记录)成为了“事实来源”。将事件提升为“一等公民”(first-class entity),会引出一些值得关注的问题。
以“订单请求”为例,订单存在两个版本:一个存储在数据库中,另一个包含在通知里。这引发了几个问题。首先,数据库更新和发送通知这两个操作必须以“原子”方式完成。试想一下,如果系统在更新数据库与发送通知的过程中途发生故障(见图 7-5),会怎样呢?最好的情况是产生重复通知;最坏的情况则是通知根本没发出去。在复杂的系统中,这类问题会变得更加棘手——我们将在第 12 章详细探讨这一问题,届时还会介绍 Kafka 的事务功能。
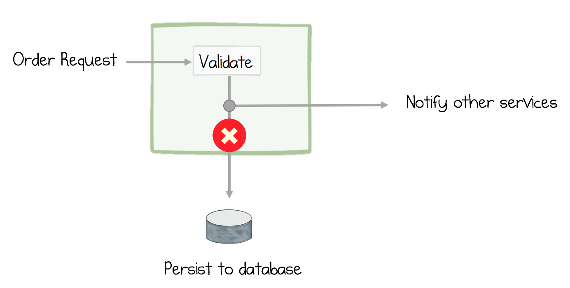
第二个问题在于,在实际开发过程中,随着代码的不断迭代和功能的实现,数据库中的数据与通知中所包含的数据很容易出现不一致。这意味着,即便数据库本身的数据是正确的,如果通知中的数据与之不符,整个系统的数据质量也会因此受损。(参见第 10 章第 95 页的“数据分歧问题”一节。)
“事件溯源”(Event Sourcing)通过将“事件流”作为首要的事实来源(primary source of truth),有效地解决了上述两个问题(见图 7-6)。当需要查询数据时,系统可以直接从事件流中“派生”出相应的读模型(read model)或事件溯源视图。
这其实非常有道理。在传统系统中,数据库被视为“事实来源”(source of truth)。从内部视角来看,这种做法是合理的。但如果从其他服务的角度来看,它们并不关心系统内部存储了什么;真正重要的是其他服务所能看到的数据。因此,从这些服务的视角而言,将“事件”作为事实来源是非常合理的。这就引出了 CQRS 模式。
命令查询职责分离 (CQRS)
正如前文所述,CQRS(命令查询职责分离)将写入路径与读取路径分离开来,并通过异步通道将二者连接起来(图 7-6)。这一理念不仅限于应用程序设计,在其他许多领域也有所体现。例如,数据库中就采用了“预写式日志”(Write-Ahead Log)这一机制。当插入或更新操作到达时,它们会立即被顺序记录到磁盘日志中。这确保了数据的持久性,使得数据库能够在确认数据安全无虞后立即向用户做出响应,而无需等待更新表、索引等各类并发数据结构这一缓慢过程的完成。2 其核心在于:(a) 一旦发生故障,可以通过日志恢复数据库的内部状态;(b) 写入操作与读取操作可以分别进行独立优化。
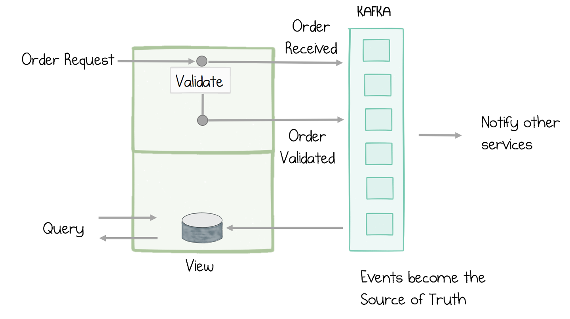
我们在应用程序中采用 CQRS,其原因大同小异。输入数据会被记录到 Kafka 中,这比直接写入数据库要快得多。通过分离读模型并对其进行异步更新,原本开销巨大的数据结构维护工作(例如索引更新)便可以合并成批处理,从而显著提升效率。这意味着,与同等规模的传统 CRUD 系统相比,CQRS 在读写性能的整体表现上更具优势。
当然,天下没有免费的午餐。其代价在于,由于读模型是异步更新的,它在时间上会略微滞后于写模型。因此,如果用户执行了一次写入操作后立即进行读取,那么刚才写入的数据可能尚未同步完成,导致用户无法“读到自己刚刚写入的内容”。正如我们在第 15 章第 142 页“通过阻塞式读取来‘消除’CQRS 的异步性”(Collapsing CQRS with a Blocking Read)一节的示例中所见,我们完全可以采取相应的策略来解决这一问题。
物化视图
CQRS(命令查询职责分离)中的“查询端”与关系数据库中的“物化视图”之间存在着密切联系。物化视图本质上是一张表,其中存储了预定义查询的结果;每当底层数据表发生变更时,该视图也会随之更新。
物化视图常被用作一种性能优化手段:它无需在用户需要数据时才临时执行查询计算,而是预先计算好查询结果并将其存储起来。例如,若需统计网站各页面的活跃用户数,通常需要扫描记录用户访问情况的数据库表,而这种计算的开销往往较大。若改用预计算方式,生成的活跃用户统计数据量会小得多,从而能够实现快速检索。因此,这类场景非常适合采用预计算。
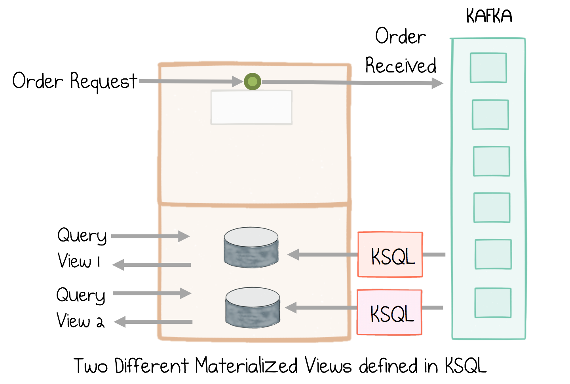
在 CQRS 架构中,我们可以利用 Kafka 构建出完全相同的机制。在“命令端”,写入操作并非直接更新数据库表,而是发送至 Kafka。我们可以根据具体业务需求,通过 Kafka Streams 或 KSQL 等工具对事件流进行转换,最终将其物化为预计算的查询结果(即物化视图)。由于 Kafka 采用发布-订阅模式,我们可以根据不同的业务场景,预先构建出多种此类视图(如图 7-7 所示)。与关系数据库中的物化视图不同,这里的底层事件与视图之间是解耦的。这意味着:(a) 两者可以独立扩展;(b) 写入过程(例如记录用户访问行为的流程)无需等待视图计算完成即可返回结果。
在第 9 章讨论“事件流作为共享的事实来源”时,这种将数据存储在日志中并创建多种派生视图的理念得到了进一步阐述。
多语言视图(Polyglot Views)
无论你面临的数据处理需求规模如何——无论是全文搜索、分析聚合、快速键值(key/value)查询,还是其他各种场景——如今总有一款数据库能完美契合你的使用需求。这也意味着,在数据库领域,那种“一套方案通吃”(one-size-fits-all)的做法已不再适用。采用 CQRS(命令查询职责分离)架构的一个额外优势在于,单一的“写模型”(write model)可以将数据同步到多个“读模型”(read model)或“物化视图”(materialized view)中。因此,你的读模型可以部署在任何类型的数据库中,甚至可以同时使用多种不同的数据库。
通过“可重放日志”(replayable log),我们可以轻松地基于同一份数据构建出多种不同的视图,每种视图都针对特定的使用场景进行了优化(见图 7-7)。一个常见的例子是:使用高性能的键值存储系统来处理网站的查询请求,同时利用 Elasticsearch 或 Solr 这类搜索引擎来支持全文搜索功能。
完整事实还是增量(Delta)?
在事件驱动(尤其是基于事件溯源/Event Sourcing)的系统中,一个关键问题是:事件究竟应该被建模为“完整事实”(例如包含订单的所有详细信息),还是建模为需要后续重组的“增量”(例如先记录一份完整的订单信息,后续事件仅记录变更内容,如“金额更新为 5 美元”、“订单已取消”等)?
我们可以打个比方:假设你正在构建一个类似 SVN 或 Git 的版本控制系统。当用户首次提交文件时,系统会将整个文件保存到磁盘上。后续的提交若涉及文件变更,则可能仅保存“增量”(即那些新增、修改或删除的行)。当用户检出(check out)某个特定版本时,系统会先读取初始版本(版本 0)的文件,然后按顺序应用后续所有的增量,从而还原出用户所请求的版本。
另一种方案则是:在每次提交时,都将当时的文件完整地保存下来。这种做法显然会占用更多的存储空间,但它的优势在于,从历史记录中提取特定版本变得既快捷又简单。不过,如果用户想要比较不同版本,系统就必须借助“差异比对”(diff)功能。
这两种处理方式同样适用于我们在日志(log)中存储的数据。以一个更贴近业务的场景为例:一份“订单”通常包含多个“订单项”(即在一次购买中,用户往往会订购多种不同的商品)。在构建处理购买行为的系统时,你可能会面临一个选择:是将订单建模为一个包含所有订单项的单一事件,还是将每个订单项都视为一个独立的事件,并在后续通过扫描这些独立的订单项来还原出完整的订单?在领域驱动设计(Domain-Driven Design)中,后一种形式的订单被称为聚合(Aggregate,因为它是由多个订单项聚合而成的),而作为外层封装实体的“订单”则被称为聚合根(Aggregate Root)。
正如软件设计中的许多问题一样,针对特定用例,人们往往对哪种方案更优有着不同的见解。不过,有一些经验法则可以作为参考。其中最重要的一条是:将事实按到达时的原样完整记录。因此,当用户创建订单时,如果订单中包含了所有的订单项,我们通常会将其作为一个完整的实体记录下来。
那么,如果用户取消了其中某一个订单项,该怎么办呢?一种简单的做法是再次记录整个订单,将其标记为“已取消”状态的聚合。但如果由于某种原因,我们无法获取完整的订单信息,而只能收到“某个订单项被取消”这一单一事件,又该如何处理呢?这时,人们可能会倾向于先从系统内部(例如数据库)查询出原始订单,将其与此次取消操作合并,从而生成一个新的“已取消订单”——其中包含了该订单所有的订单项。通常情况下,这并不是一个好主意,原因在于:(a) 我们没有如实记录所接收到的原始信息;(b) 需要从数据库中查询订单,这会削弱 CQRS(命令查询职责分离)架构所带来的性能优势。一个基本原则是:记录你所接收到的内容——如果只收到了一项明细,那就只记录这一项。至于合并操作,可以在读取数据时进行。
反过来说,出于同样的原因,在事件到达时将其拆分为子事件,通常也不是一种好的做法。总之,基本原则就是:以不可变的方式,原原本本地记录下你所接收到的内容。
使用 Kafka 实现事件溯源(Event Sourcing)与 CQRS
Kafka 提供了两种不同的 API,能够更轻松地构建和管理基于 Kafka 中存储的事件所派生出的 CQRS 风格视图。Kafka Connect API 及其相关的连接器(Connector)生态系统提供了一种开箱即用的机制,用于将数据推送到各种数据库、数据源和数据接收端(Data Sink),或从中拉取数据。此外,Kafka Streams API 还内置了一个简单的嵌入式数据库,称为“状态存储”(State Store)(详见第 14 章第 135 页的“窗口、连接、表与状态存储”一节)。
在本节的后续内容中,我们将介绍一些利用这些工具实现事件溯源和 CQRS 的实用模式。
在 Kafka Streams 中利用表(Table)和状态存储构建进程内视图
Kafka Streams API 为实现事件溯源和 CQRS 提供了最简单的机制之一,因为它允许你直接在 Kafka Streams API 内部原生实现视图——无需任何外部数据库!
最简单的情况是将 Kafka 中的事件流转换为可在本地查询的“表”(Table)。例如,将“客户”(Customer)事件流转换为一个可以通过 CustomerId 进行查询的 Customers 表,仅需一行代码:
KTable<CustomerId, Customer> customerTable = builder.table("customer-topic");这行代码完成了以下几项工作:
- 订阅了 customer 主题中的事件。
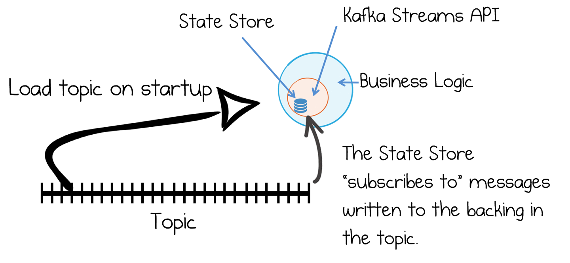
- 将偏移量(Offset)重置为最早位置,并将所有“客户”事件加载到 Kafka Streams API 中。这意味着它将数据从 Kafka 加载到了你的服务中。(通常会使用“压缩主题”(Compacted Topic)来缩短初始加载时间或最坏情况下的加载时间。)
- 将这些事件推送到“状态存储”(见图 7-8)中——这是一个位于 Kafka Streams API 内部、驻留在本地磁盘上的哈希表。最终,这在本地磁盘上形成了一个“客户”表,支持通过键(Key)进行查询或执行范围扫描。
在第 15 章中,我们将通过一系列更丰富的代码示例,展示如何利用表(table)和状态存储(state store)来创建不同类型的视图,并探讨这种方法如何实现扩展。
使用 Kafka Connect 通过数据库直写 Kafka 主题
将事件导入 Kafka 的一种方式是:通过数据库表“直写”(write through)到 Kafka 主题。严格来说,这并非基于“事件溯源”(Event Sourcing)或 CQRS(命令查询职责分离)的模式,但它依然非常实用。
如图 7-9 所示,订单服务(orders service)将订单写入数据库。这些写入操作通过 Kafka 的 Connect API 被转换为事件流。这会触发后续的处理流程,进而对订单进行验证。当“订单已验证”(Order Validated)事件返回至订单服务时,数据库会更新为订单的最终状态,随后该调用才会返回给用户。
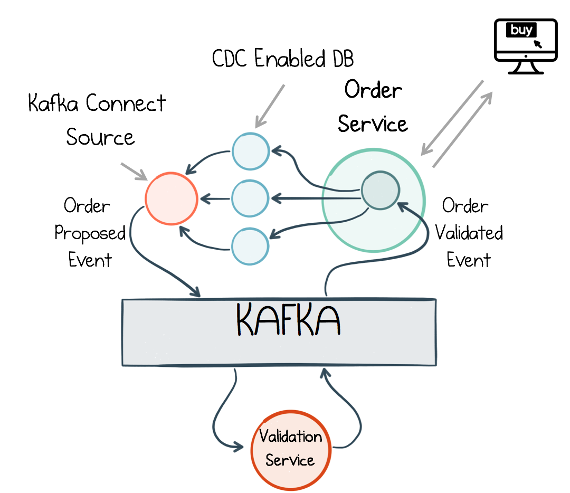
实现这一目标最可靠、最高效的方法是使用一种称为“变更数据捕获”(Change Data Capture,简称 CDC)的技术。大多数数据库会将每一项修改操作写入“预写日志”(write-ahead log);一旦数据库发生错误,便可据此恢复其状态。许多数据库还提供了相应的机制,用于捕获已提交的修改操作。实现 CDC 的连接器(connector)会利用这些机制,将数据库操作转换为事件,并将其发布到诸如 Kafka 之类的消息系统中。由于 CDC 采用了原生的“事件”接口,它具有以下优势:(a) 高效——连接器通过监控文件或在变更发生时直接触发来获取数据,无需通过数据库的主 API 发起查询;(b) 准确——如果通过数据库的主 API 发起查询,当同一行数据在轮询周期内发生多次变更时,往往会漏掉其中某些操作。
在 Kafka 生态系统中,并非所有数据库都支持 CDC,但该生态系统正在不断壮大。目前,在 Kafka Connect 中支持 CDC 的主流数据库包括 MySQL、Postgres、MongoDB 和 Cassandra 等。此外,针对 Oracle、IBM、SQL Server 等数据库,也有相应的专用 CDC 连接器。你可以在 Kafka Connect 的主页上查看完整的连接器列表。
这种“以数据库为前端”的方法的优势在于,它提供了一个一致性点:数据通过该数据库写入 Kafka,这意味着你可以始终读取到自己刚才写入的数据。
在 Kafka Streams 中通过状态存储直写 Kafka 主题
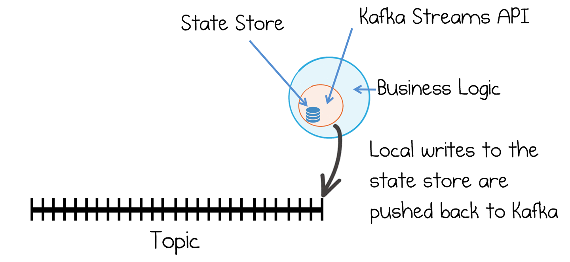
在 Kafka Streams 内部,也可以实现同样的“通过数据库直写 Kafka 主题”的模式,只不过这里的数据库被替换成了 Kafka Streams 的“状态存储”(state store,见图 7-10)。这种方式不仅具备“借助 CDC 通过数据库直写”所带来的所有优点,还额外具备以下优势:
- 状态存储位于本地,访问速度更快。
- 由于状态存储由 Kafka Streams 封装,它可以参与事务处理;因此,服务所发布的事件与对状态存储的写入操作能够保持原子性。
- 配置更为简便,因为只需使用一套 API 即可(无需配置外部数据库,也无需配置 CDC 连接器)。
我们在第 14 章第 135 页的“窗口、连接、表与状态存储”(Windows, Joins, Tables, and State Stores)一节中,讨论了这种利用状态存储来保存应用级状态的做法。
利用 CDC 解锁遗留系统
在实际项目中,往往既包含遗留部分,也涉及系统更新。虽然“推倒重来”式的彻底重构有时确实有其必要,但循序渐进的改进通常更容易被各方所接受。
遗留系统的问题在于,人们往往有充分的理由想要摆脱它——最常见的原因就是它难以修改。然而,遗留应用中的绝大多数业务操作最终都会汇聚到数据库中。这意味着,无论遗留代码有多么糟糕、令人费解,数据库都提供了一个清晰的切入点,让我们能够介入现有的业务流程;通过 CDC(变更数据捕获)技术,我们可以从中提取出事件。一旦获取了事件流,便可以接入新的事件驱动型服务,从而实现从旧系统向新系统的平稳、渐进式演进(图 7-11)。
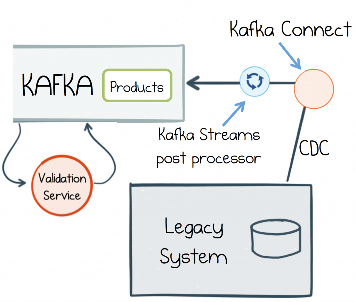
例如,我们现有的遗留系统中可能包含用于管理和更新产品目录的功能。我们可以通过将遗留系统数据库中的数据集导入 Kafka 来保留这一功能。随后,该产品目录便可在验证服务或其他任何服务中重复使用。
在对接遗留系统(或任何外部数据源)时,一个常见问题是数据格式未必总是规范的。如果遇到这种情况,可以考虑增加一个后处理阶段。Kafka Connect 的“单条消息转换”(Single Message Transforms)功能非常适合此类操作(例如进行简单的调整或数据丰富);而 Kafka Streams API 则功能更为强大,既能处理从简单到极其复杂的数据操作,也能预先计算出其他服务所需的数据视图。
查询在数据库中创建的“读优化”视图
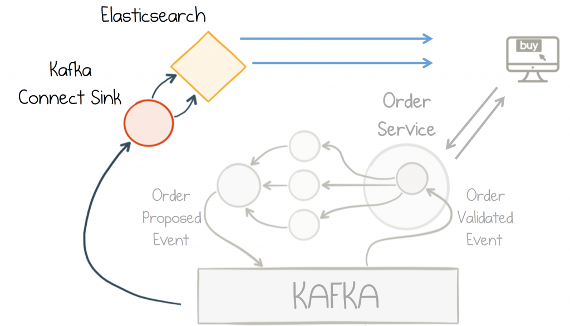
另一种常见的模式是利用 Connect API,在数据库内部构建“读优化”的事件溯源(event-sourced)视图。借助 Kafka Connect 提供的各种 Sink Connector(数据汇连接器),用户可以轻松、快速地在多种不同的数据库中创建此类视图。正如我们在前一节中所讨论的,这类视图通常被称为“多语言视图”(polyglot views),它们使系统架构能够兼容多种不同的数据存储技术。
在图 7-12 的示例中,我们使用了 Elasticsearch,因为它具备强大的索引和查询功能;事实上,无论你面临何种类型的问题,如今总能找到一款合适的数据库来解决。另一种常见的模式是利用 Kafka Streams、KSQL 或 Kafka Connect 的“单消息转换”(Single Message Transforms)功能,将数据预先计算并构建为“物化视图”(Materialized View)(详见本章第 62 页的“物化视图”一节)。
内存镜像(Memory Images)/ 预填充缓存(Prepopulated Caches)
最后,我们还要提一下一种名为“内存镜像”(MemoryImage,见图 7-13)的模式。这是由 Martin Fowler 提出的一个术语,本质上是指将整个数据集缓存到内存中(以便进行查询),从而无需依赖外部数据库。
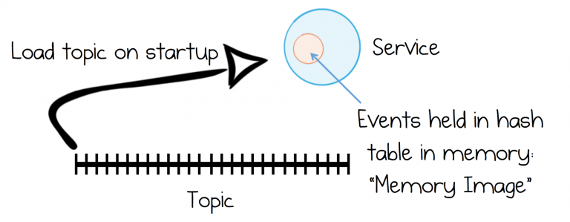
内存镜像为那些 (a) 可完全放入内存,且 (b) 能够在合理时间内完成加载的数据集,提供了一种简单而高效的模型。为了缩短加载时间,通常会利用“压缩主题”(compacted topic)来保存事件日志的快照——该快照仅包含最新的事件集合,而不包含任何历史版本信息。这种“内存镜像”模式既可以手动构建,也可以通过 Kafka Streams 结合内存状态存储(in-memory state stores)来实现。该模式适用于那些无需将数据溢写至磁盘的高性能应用场景。
事件溯源视图
在本书后续内容中,我们将使用“事件溯源视图”(图 7-14)这一术语,来指代在某个服务中创建的查询资源(如数据库、内存镜像等);该资源所包含的数据由另一个服务产生(并因此归其所有)。
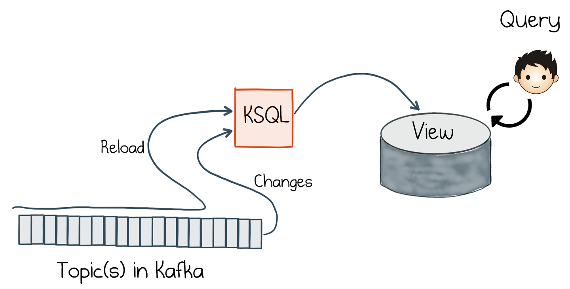
基于事件溯源(Event Sourcing)的视图与传统的数据库、缓存等存储形式的区别在于:虽然它能够以用户所需的任何形式呈现数据,但其数据直接源自事件日志,且随时可以重新生成。
例如,我们可以创建一个包含订单、支付和客户信息的视图,并过滤掉所有非美国境内的发货记录。如果我们在修改视图定义(比如将其调整为包含发货至加拿大的订单)时,能够根据事件日志自动完整地重建该视图,那么它就是一个基于事件溯源的视图。
在事件溯源的术语体系中,这种视图相当于“投影”(Projection)。
总结
在本章中,我们探讨了“事件”如何超越单纯的通知或状态转移机制。事件溯源(Event Sourcing)的核心在于:使用与传递信息完全相同的媒介来保存状态,并确保每一次变更都以不可篡改的方式被记录下来。正如我们在第 57 页“数据版本控制”一节中所述,与传统的应用程序设计方法相比,这种方式使得在发生故障或数据损坏时,进行恢复变得更加简单、高效。
CQRS(命令查询职责分离)则更进一步,它将这些原始事件转化为“事件溯源视图”——即一种可查询的端点,该端点直接从事件日志中派生而来(且支持重新派生)。CQRS 的重要价值在于其良好的扩展性:它能够分别对读模型和写模型进行独立优化。
此外,我们还研究了将事件写入日志的多种模式,并探讨了如何利用 Kafka Streams、Kafka Connect 接口以及我们所选用的数据库来构建视图。
从架构师或程序员的角度来看,转向这种基于事件溯源的方法,将对应用程序的设计产生深远影响。在事件溯源和 CQRS 架构中,事件被视为“一等公民”。这使得系统能够将服务内部的数据与它同其他服务共享的数据直接关联起来。后续章节中,我们将探讨如何利用 Kafka 的事务 API(Transactions API)将这些要素串联在一起。此外,我们还将把本章介绍的理念扩展至跨团队协作场景中,即第 9 章所讨论的“将事件流作为共享的事实来源(shared source of truth)”这一方法。
1 参见 https://martinfowler.com/eaaDev/EventSourcing.html 和 http://bit.ly/2pLKRFF 。
2 一些数据库(例如 DRUID)将这种分离体现得非常明确。而另一些数据库则会进行阻塞,直到索引完成更新。