第九章 事件流作为共享的事实来源
正如本书第二部分所述,事件是系统设计中的一项实用工具,能够实现通知、状态转移和解耦。几十年来,消息系统一直利用这些特性在不同系统间传递事件;但直到最近几年,消息系统才开始被用作存储层,用以保留流经其中的数据集。这催生出一种有趣的架构模式:企业将核心数据集存储为集中式的事件流,同时天然具备了消息代理(message broker)所带来的解耦优势。与传统消息代理(在消息被读取后即将其删除)不同,这种模式会保留历史数据,并供任何需要的团队随时访问。这与“事件溯源”(Event Sourcing,见第 7 章)中的理念,以及 Pat Helland 提出的“外部数据”(data on the outside)概念密切相关。ThoughtWorks 将这种模式称为“以事件流作为事实来源”(event streaming as the source of truth)。
“由内而外”的数据库
“将数据库由内而外翻转”(turning the database inside out)这一表述由 Martin Kleppmann 提出。其核心思想在于:数据库由若干核心组件构成——包括提交日志(commit log)、查询引擎、索引和缓存。与其像传统数据库那样将这些功能混杂在一个“黑盒”之中,不如利用流处理工具将它们拆解为独立的模块。这些模块可以分布在不同位置,并通过日志将彼此串联起来。在此架构中,Kafka 充当了“提交日志”的角色;Kafka Streams 这类流处理工具则用于构建索引或视图。这些视图表现为一种持续更新的缓存,存在于应用程序内部或其周边(见图 9-1)。
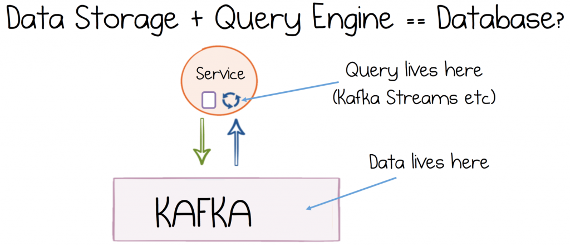
举个例子,我们可以设想一个简单的图形用户界面(GUI)应用程序,它允许用户在可滚动的网格中浏览订单、支付和客户信息。由于用户可能会快速上下滚动网格,因此通常需要在本地缓存数据。但在流处理模型中,我们无需定期轮询数据库并将结果缓存起来,而是可以定义一个视图,该视图精确对应可滚动网格所需的数据集,并由流处理器负责将其物化(materialize)。因此,我们不再是从数据库查询数据后再额外添加缓存层,而是主动将数据推送到需要它的地方,并在那里进行处理(即在 GUI 内部,紧邻我们的代码)。
虽然我们将“将数据库由内而外翻转”(turning the database inside out)称为一种“模式”,但更准确地说,它其实是一个类比——一种解释“什么是流处理”的独特视角。而且,这是一个非常有力的类比。它之所以能引起人们的共鸣,部分原因在于我们普遍认为将业务逻辑推入数据库并非良策。反过来,将数据推入代码中,则为融合数据与代码开辟了广阔的空间。流处理彻底颠覆了传统处理数据与代码的方式,鼓励我们将数据引入应用层——在真正需要的地方创建表、视图和索引。
这一理念在其他领域也有所体现。例如,Clojure 社区就曾探讨过“解构数据库”(deconstructing the database)的概念。正如我们在第 7 章中所讨论的那样,这与“事件溯源”(Event Sourcing)和“多语言持久化”(polyglot persistence)存在重叠之处。但这一理念最初是由 Jay Kreps 在 2013 年提出的;他将其称为“解绑”(unbundling),并将其置于一个略有不同的语境中——这一点至关重要:
这里存在一种类比:日志在分布式数据库内部数据流中所扮演的角色,与它在大型组织中进行数据集成时所扮演的角色是相似的……如果换个角度审视,你可以将整个组织内的系统和数据流看作一个单一的分布式数据库。你可以将各种面向查询的系统(如 Redis、SOLR、Hive 表等)视为该数据库中针对数据的不同索引;而将 Storm 或 Samza 这类流处理系统,视为一套非常完善的触发器(trigger)和视图物化(view materialization)机制。我注意到,传统数据库领域的从业者非常喜欢这种视角,因为它终于解释了人们使用各种不同数据系统的真正用意——它们本质上不过是不同类型的索引而已!
Jay 的描述之所以有趣,在于他将这种类比扩展到了整个公司的层面。其核心洞察在于:流处理将“数据存储”的职责与“数据查询”的机制分离开来。因此,公司内部可能存在一个共享的事件流(例如针对支付业务的事件流),而公司各部门则可以基于此构建多种专门的视图(见图 9-2)。这为传统的数据集成机制提供了一种重要的替代方案。具体而言:
- 日志以“共享事实来源”(shared source of truth)的形式集中提供数据,且其契约(contract)尽可能简单。这使得各个应用程序之间能够保持松耦合。
- 查询功能并非共享的,而是属于各个服务私有;这让各团队能够保留对其所用数据集的控制权,从而实现快速迭代。
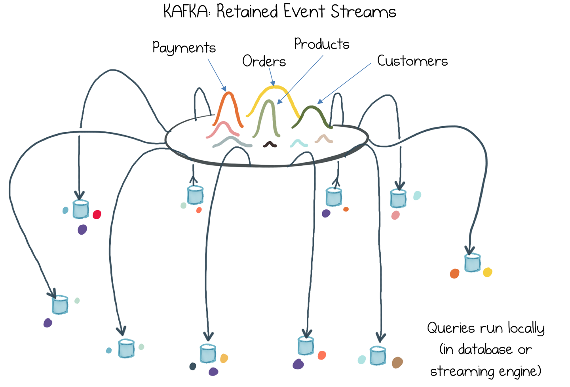
正如我们将在第 10 章中看到的,这种理念能够带来进一步的优化:每个视图都可以针对特定的使用场景进行专门优化。这与关系型数据库中使用“物化视图”(materialized views)来构建面向特定场景、针对读取操作进行优化的数据集,在本质上是相似的。当然,与关系型数据库中的物化视图不同,这里的视图与底层数据是解耦的;如果需要进行变更,完全可以根据日志重新生成这些视图。(参见第 7 章第 62 页的“物化视图”一节。)
总结
本章引入了一个类比:流处理可以被视为一种“由内而外翻转”或“解绑”的数据库。在这种类比中,数据存储(即日志)的职责与查询数据的机制(即流处理 API)被分离开来。这使得我们能够创建各种视图,并将它们精确地嵌入到所需的位置——无论是另一个应用程序、另一个地理区域,还是另一个平台之中。采用这种“将数据推向代码”的方式,主要有两个驱动因素:
- 作为一种性能优化手段,通过实现数据本地化来提升效率。
- 在组织内部实现数据解耦,同时确保数据始终与单一的“事实来源”(source of truth)保持紧密关联。
因此,从组织层面来看,这种模式构成了一种“数据库的数据库”:单一的事件数据存储库为多个视图提供数据源,而每个视图又都能根据特定团队的需求灵活调整。