第十四章 Kafka Streams 和 KSQL
在构建事件驱动型服务时,Kafka Streams API 为应对分布式、异步环境提供了最完备的工具集。Kafka Streams 专为执行流处理计算而设计。我们在第 2 章中探讨过一个简单的应用示例——处理移动设备所产生的“应用打开/关闭”事件;此外,在第 6 章中,我们也涉及了其有状态(stateful)的相关要素。由此,我们可以构建出三种类型的服务:事件驱动型服务、流处理服务以及有状态流处理服务。
在本章中,我们将深入探讨这一用于有状态流处理的独特工具,并介绍其功能强大的声明式接口——KSQL。
基于 Kafka Streams 和 KSQL 构建的简易电子邮件服务
Kafka Streams 是 JVM(Java、Scala、Clojure 等)平台上进行流处理的核心 API。它基于一种领域特定语言(DSL),提供了一种声明式的接口;通过该 DSL,可以对数据流进行连接(join)、过滤(filter)、分组(group)或聚合(aggregate)操作。它还提供了一系列函数式机制(如 map、flatMap、transform、peek 等),用于对每条消息进行定制化处理。值得一提的是,在构建服务时,你可以将这两种方式结合起来使用:声明式接口为类 SQL 操作提供了高层抽象,而函数式方法则赋予了你极大的灵活性,让你能够根据需要编写任意自定义代码。
那么,如果你的运行环境并非 JVM,该怎么办呢?这时可以使用 KSQL。KSQL 为 Kafka Streams API 提供了一套简单、交互式的类 SQL 封装。它可以独立运行(例如通过边车(Sidecar)模式),并支持远程调用。由于 KSQL 底层正是基于 Kafka Streams API,因此我们同样可以利用它进行声明式的数据处理与分析。此外,我们还可以通过实现用户自定义函数(UDF)来执行定制化处理;或者更常见的一种做法是,将处理后的数据输出到 Kafka 主题(Topic),然后利用原生 Kafka 客户端(无论你的服务是用什么语言编写的)逐条处理这些数据流。无论采用哪种方式,这些工具都能让我们以异步、非阻塞且无需协调(coordination-free)的方式来建模业务操作。
让我们来看一个更具体的例子。假设我们有一个服务,专门负责向“白金级”客户发送电子邮件(图 14-1)。我们可以将此任务拆分为两个部分:首先,通过将订单流与客户表进行连接,筛选出“白金级”客户;其次,编写代码来构建并发送电子邮件。其中,前者可以通过 DSL 来实现,而后者则通过针对每条消息的函数来完成:
// 连接客户与订单
orders.join(customers, Tuple::new)
// 筛选出白金客户的已确认订单
.filter((k, tuple) -> tuple.customer.level().equals(PLATINUM)
&& tuple.order.state().equals(CONFIRMED))
// 为每一对客户/订单发送电子邮件
.peek((l, tuple) -> emailer.sendMail(tuple));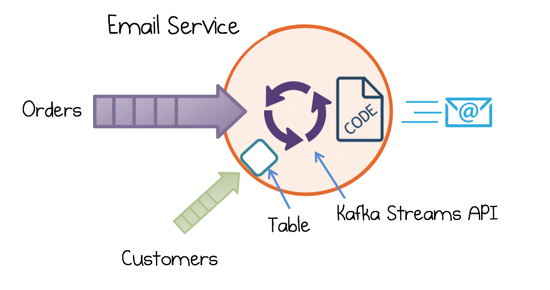
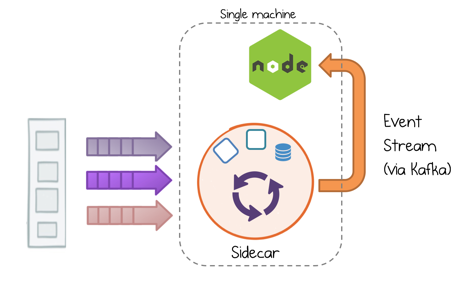
我们可以使用 KSQL 执行相同的操作(图 14-2)。其模式是一致的:通过声明式语句对事件流进行解析,然后逐条记录地进行处理:
// 为白金客户创建已确认订单的数据流
ksql> CREATE STREAM platinum_emails AS SELECT * FROM orders
    WHERE client_level == 'PLATINUM' AND state == 'CONFIRMED';
随后,我们利用 Kafka 的 Node.js API(尽管也支持多种其他编程语言)将邮件发送程序实现为一个简单的消费者,并以“边车”(sidecar)模式运行 KSQL。
窗口、连接、表与状态存储
第 6 章介绍了在 Kafka Streams API 中维护完整表(Table)的概念,从而使服务具备了“有状态”的特性。本章将进一步探讨流(Stream)和表在底层是如何实现的,并介绍其他一些核心功能。
让我们再次回顾一下“电子邮件服务”的示例——即发送一封电子邮件来确认新订单的付款,如图 14-3 所示。在此场景中,我们使用了“流与流的连接”(stream-stream join);该机制会等待“订单”(Order)事件和“付款”(Payment)事件同时出现在电子邮件服务中,随后才会触发发送邮件的逻辑。这种连接方式在逻辑上非常类似于“与”(AND)运算。
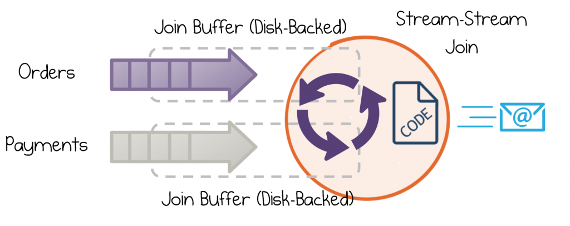
传入的事件流会在一段预定义的时间内被缓存(这一机制称为“保留期”)。为了避免将所有缓存数据都保存在内存中,系统会利用“状态存储”(即基于磁盘的哈希表)将超出内存容量的缓存数据溢写到磁盘上。因此,无论后续出现什么事件,系统都能从缓存中快速检索到对应的事件,从而完成连接(join)操作。
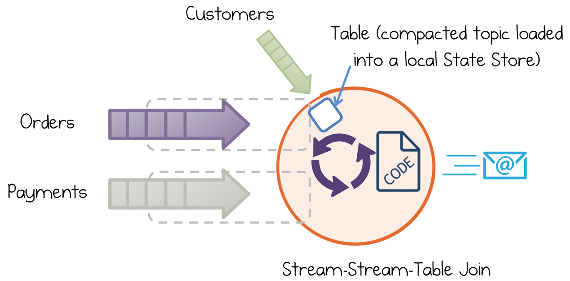
Kafka Streams 还能管理完整的“表”(table)。表是某个完整主题(topic)在本地的一种呈现形式——通常经过了“压缩”(compaction)处理——并以键值对的形式保存在状态存储中。(你也可以将其理解为一种具有无限保留期的流。)在服务架构中,这类表常用于数据丰富(enrichment)操作。例如,若要查询客户的电子邮件地址,我们可以使用一张从 Kafka 的“客户”(Customers)主题加载而来的表。
使用表的一大优势在于,它的行为方式与数据库中的表非常相似。因此,当我们将“订单”流与“客户”表进行连接时,无需考虑保留期、时间窗口或其他复杂的因素。图 14-4 展示了“订单”、“支付”和“客户”三者之间的三向连接,其中“客户”是以表的形式呈现的。
Kafka Streams 中实际上有两种类型的表:KTable 和 Global KTable。当服务仅运行一个实例时,两者的表现并无二致。然而,如果我们对服务进行横向扩展(即同时运行四个实例),就会发现它们的行为有所不同。这是因为 Global KTable 采用的是广播机制:每个服务实例都会获得整个表的一份完整副本;而普通的 KTable 则是分区的:数据集被分布在各个服务实例中。
表是采用广播方式还是分区方式,会影响其执行连接(join)操作的方式。对于 Global KTable,由于每个节点上都存有完整的表,我们可以基于任意属性进行连接,这非常类似于数据库中的外键连接。但 KTable 则不然:由于它是分区的,因此只能通过主键进行连接——这与连接两个流(stream)时必须使用主键的逻辑是一样的。因此,若要基于非主键属性来连接 KTable 或流,就必须执行“重新分区”(repartition)操作。相关内容将在第 15 章第 145 页的“通过重设键(Rekey)实现连接(Join)”一节中讨论。
简而言之,Global KTable 非常适合用作查找表(lookup table)或进行星型连接(star join),但由于其采用广播机制,会占用更多的磁盘空间。而 KTable 则支持在数据集较大时对服务进行横向扩展,但可能需要对数据进行“重设键”(rekey)操作。1
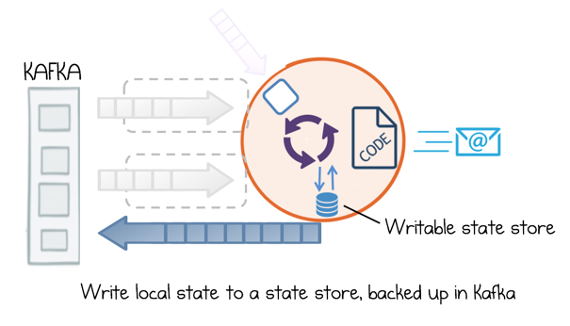
状态存储(state store)的另一个用途是保存信息,这就像我们将数据写入普通数据库一样(见图 14-5)。所有保存的数据在后续(例如系统重启后)均可被再次读取。例如,我们可以为电子邮件服务提供一个管理接口,用于展示已发送邮件的统计数据。这些统计信息可以存储在状态存储中;它们不仅会保存在本地,还会通过所谓的“变更日志主题”(changelog topic)备份到 Kafka 中,从而继承 Kafka 所提供的所有持久性保障。
总结
本章简要介绍了流(Streams)、表(Tables)和状态存储(State Stores)——这是流处理应用中最重要的三个要素。流是无限的,我们以单条记录为单位对其进行处理。表代表完整的数据集,并在本地物化;我们可以像连接数据库表一样对其进行连接(join)。状态存储的作用类似于专用数据库,我们可以直接对其进行读写,存储所需的任何信息。当然,这些功能仅仅是冰山一角;无论是 Kafka Streams 还是 KSQL,都提供了更为丰富的功能(其中部分内容将在第 15 章探讨),但所有这些功能归根结底都是建立在这些基础概念之上的。
1 这两者之间的区别实际上要更为微妙一些。