第三章 Kafka 是否如你所想?
有一个关于大象和一群盲人的古老寓言。这些人此前从未接触过大象。其中一人摸到象腿,断言道:“它就像一棵树。”另一人摸到象尾,说道:“它就像一根绳子。”还有一人摸到象鼻,则称:“它就像一条蛇。”就这样,每位盲人都从各自的角度去感知大象,并由此得出了关于“大象究竟是什么”的、略有差异的结论。当然,大象确实兼具这些特征,但它终究就是一头大象!
同样地,人们在了解 Kafka 时,往往也倾向于从特定的视角出发。这些视角通常都是准确的,但它们往往只能反映出整个平台全貌中的某一个侧面。在本章中,我们将探讨几种常见的视角。
Kafka 类似于异步版的 REST?
Kafka 提供了一种用于连接各程序的异步协议,但它与 TCP(传输控制协议)、HTTP 或 RPC 协议等存在显著区别。这种区别在于它引入了 Broker(代理)。Broker 是一种独立的基础设施组件,负责将消息广播给所有感兴趣的程序,并根据需要将消息存储起来。因此,它非常适合处理数据流或“发送即忘”(fire-and-forget)式的消息传递。
有些使用场景则超出了 Kafka 的核心适用范畴。典型的例子是“请求-响应”模式:假设你有一个查询客户信息的服务,通过调用 getCustomer() 方法并传入 CustomerId,即可获得包含客户详细信息的数据文档。你可以利用 Kafka 的两个主题(Topic)——一个用于传输请求,另一个用于传输响应——来实现这种“请求-响应”交互。虽然确实有人这样构建系统,但在这种场景下,Broker 的作用其实非常有限:既不需要广播功能,也不需要存储功能。那么问题来了:在这种情况下,使用 HTTP 这类无状态协议是否会更合适?
总而言之,Kafka 是一种供程序交换信息的机制,但其核心应用领域在于“基于事件的通信”。这里的“事件”指的是具有业务价值的事实——这些事实不仅对多个服务有用,而且值得被持久化保存下来。
Kafka 类似于企业服务总线(ESB)吗?
如果我们把 Kafka 看作一个消息系统——它拥有能够从各种接口和数据存储中拉取数据或向其推送数据的 Connect 接口,以及能够在数据传输过程中对其进行处理的流处理 API——那么它看起来确实有点像 ESB(企业服务总线)。两者的区别在于,ESB 侧重于集成遗留系统和现成的商业软件,其所采用的消息层通常是瞬态的,吞吐量相对较低,且往往倾向于使用“请求-响应”式协议(详见前文)。
相比之下,Kafka 是一个流处理平台,它更关注高吞吐量的事件处理和流处理。Kafka 集群本质上是一个分布式系统,具备高可用性、数据存储能力以及线性的横向扩展能力。这与传统的、仅限于单机运行的消息系统有着本质区别;即便传统系统支持扩展,其扩展性也往往无法贯穿整个端到端的链路。借助 Kafka Streams 和 KSQL 等工具,开发者可以编写简单的程序,在事件传输和演进的过程中对其进行处理。这意味着数据库的处理能力被引入到了应用层(通过 API),从而摆脱了共享 Broker 的局限。这一点至关重要。
在某些技术圈子中,ESB 常受到诟病。这种批评源于过去 15 年间 ESB 技术的发展模式:ESB 通常由中心化的团队管控,由他们来定义数据模式(schema)、消息流向、校验规则,甚至是数据转换逻辑。在实际应用中,这种中心化的方式往往会束缚组织,导致各个应用程序和服务难以按照各自的节奏进行演进。
ThoughtWorks 最近也指出了这一点,建议用户在使用 Kafka 时,应避免重蹈 ESB 的覆辙。同时,他们还建议用户探索将“事件流”作为“事实来源”(source of truth)——我们将在第 9 章中详细讨论这一概念。这些建议都非常中肯。
因此,虽然 Kafka 在外观上可能与 ESB 有些相似,但正如本书后续内容所展示的那样,两者有着本质的区别。Kafka 提供了远超 ESB 的吞吐量、可用性和存储能力;目前已有数百家企业通过单一的 Kafka 集群来处理其核心业务数据。此外,流处理促使各项服务能够保持对自身(尤其是数据)的控制权,而非依赖单一的中心化团队或平台来进行统一编排(orchestration)。因此,尽管在组织内部署一个核心 Kafka 集群的做法相当普遍,但这种模式之所以行之有效,恰恰在于其简单性——它本质上仅提供大规模、高可用的数据传输与存储能力。这一点在事件驱动型服务的核心理念中得到了充分体现:集中管理不可变的事实流;分散行动、调整和变更的自由。
Kafka 类似于数据库?
有些人喜欢将 Kafka 比作数据库,因为它确实具备一些类似的功能。它提供存储能力——在 Kafka 的主题(Topic)中存储数百太字节(TB)的数据并不罕见。它还拥有 SQL 接口,允许用户定义查询,并针对日志中存储的数据执行这些查询;查询结果可以导入到视图中,供用户直接查询。此外,它还支持事务。这些特性听起来确实非常有“数据库”的味道!
虽然 Kafka 具备传统数据库的许多要素,但更准确地说,它是一个“由内而外翻转”的数据库(参见第 9 章第 87 页的“‘由内而外’的数据库”一节)。它不仅用于存储数据,还能实时处理数据并创建视图。尽管你完全可以将数据集存入 Kafka,并通过 KSQL 进行查询以获取结果——这与在传统数据库中的操作非常相似——但 KSQL 和 Kafka Streams 的设计初衷是针对“持续计算”进行优化的,而非“批处理”。
因此,虽然这种类比并非完全错误,但并不十分贴切。Kafka 的设计核心在于数据传输,并在传输过程中对数据进行处理。它更侧重于实时处理,其次才是长期存储。
Kafka 究竟是什么?一个流处理平台
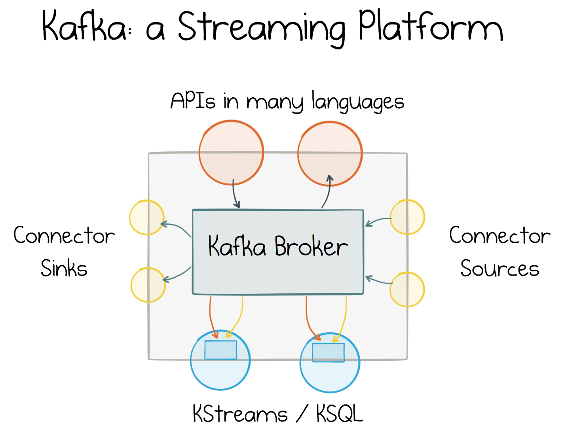
如图 3-1 所示,Kafka 是一个流处理平台。其核心是一个由多个 Kafka Broker 组成的集群(将在第 4 章详细讨论)。你可以通过多种客户端 API(支持 Go、Scala、Python、REST 等语言)与该集群进行交互。
针对流处理,Kafka 提供了两种 API:Kafka Streams 和 KSQL(我们将在第 14 章讨论)。它们本质上是针对“传输中数据”(data in flight)的数据库引擎,允许用户对数据流进行过滤、连接(join)、聚合、状态存储,并对不断变化的数据流执行各种自定义函数。这些 API 支持有状态处理,即它们能够像传统数据库一样维护数据表(详见第 6 章第 47 页的“让服务具备‘状态’”一节)。
第三种 API 是 Connect。它拥有一个完整的连接器(Connector)生态系统,能够与各类数据库或其他端点对接,既可以从这些系统拉取数据,也可以将数据推送到 Kafka。此外,还有一系列实用工具——例如用于连接不同集群的 Replicator 和 Mirror Maker,以及用于验证和管理数据模式(Schema)的 Schema Registry——它们共同作用于在 Kafka 中传输的消息;Confluent 平台中也包含其他多种此类工具。
流处理平台将这些工具整合在一起,旨在将“静态数据”(data at rest)转化为在整个组织内流动的数据。人们常将其比作“中枢神经系统”。Kafka Broker 具备出色的扩展能力、数据存储能力以及不间断运行的特性,使其成为连接部门或组织内各类分散应用程序与服务的独特工具。通过 Connect 接口,企业可以更轻松地从遗留系统转型——它能“解锁”那些原本被隐藏的数据集,并将其转化为事件流。而流处理功能则允许应用程序和服务直接在这些事件流之上嵌入业务逻辑。