第十五章 构建流处理服务
订单验证生态系统
在对 Kafka Streams 有了基本了解之后,接下来我们将探讨构建小型流处理服务应用所需的相关技术。本章将围绕一个简单的订单处理工作流程展开:该流程通过响应 HTTP 请求来验证并处理订单,实现了标准 REST 接口的同步模式与事件驱动的异步模式之间的相互转换。
从图 15-1 的左侧开始,REST 接口提供了用于提交(POST)和获取(GET)订单的方法。提交订单会在 Kafka 中触发一个“订单已创建”(Order Created)事件。三个验证引擎(分别针对欺诈、库存和订单详情)会订阅这些事件并并行执行;根据各自验证是否成功,它们会分别输出“通过”(PASS)或“失败”(FAIL)的结果。这些验证结果会被发送到一个独立的 Kafka 主题(即“订单验证”主题),从而确保“订单服务”与“订单”主题之间始终保持“单一写入者”的关系。1 各项验证结果会在“订单服务”中进行汇总,该服务随后会根据汇总后的结果,将订单状态更新为“已验证”或“失败”。已验证的订单会汇集到“订单视图”(Orders view)中,供后续进行历史查询。这正是 CQRS(命令查询职责分离)设计模式的一种实现方式(详见第 7 章第 61 页的“命令查询职责分离”一节)。此外,电子邮件服务负责发送确认邮件。
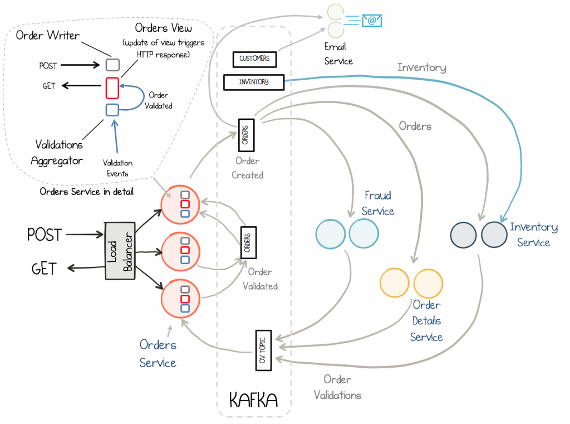
库存服务既负责验证订单,又负责为此次购买预留库存——这是一个颇具挑战的问题,因为它涉及将读操作与写操作以原子方式关联起来。我们将在本章后续部分详细探讨这一问题。
连接-过滤-处理 (Join-Filter-Process)
大多数流处理系统都采用了一种通用的模式:先准备好一组数据流,然后逐个事件地进行处理。该模式包含三个步骤:
- 连接 (Join)。 利用领域特定语言 (DSL) 将来自其他服务的数据流和表进行连接。
- 过滤 (Filter)。 剔除不需要的数据。在此阶段,通常也会进行聚合操作。
- 处理 (Process)。 将连接后的结果传递给一个函数,并在其中执行业务逻辑。业务逻辑的输出会被推送到另一个数据流中。
这种模式在大多数服务中都很常见,其中最典型的例子莫过于“电子邮件服务”:它将订单、支付和客户信息进行连接,并将结果传递给一个负责发送电子邮件的函数。该模式既可以通过 Kafka Streams 实现,也可以通过 KSQL 实现,两者效果相同。
Kafka Streams 中的事件溯源视图
为了让用户能够通过 HTTP GET 请求获取订单(包括历史订单),订单服务(Orders service)会创建一个可查询的“事件溯源视图”(Event-Sourced View)。(请参阅第 7 章第 71 页的“事件溯源视图”一节。)其实现方式是将订单数据推送到一组状态存储(state stores)中;这些状态存储被分布在“订单视图”的三个实例上,从而实现了负载与存储在各实例间的均衡分配。
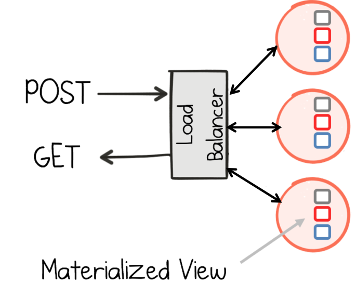
由于数据经过了分区处理,系统能够实现水平扩展(Kafka Streams 支持动态负载重平衡);但这也意味着,GET 请求必须被路由至正确的节点——即存储有所需键(key)对应分区的那个节点。在 Kafka Streams 中,这一过程通过“交互式查询”(interactive queries)功能自动完成。2
实际上,这包含两个部分。第一部分是查询,它定义了哪些数据会进入视图。在本例中,我们根据键(key)对订单进行分组(因此新订单会覆盖旧订单),并将结果写入状态存储(state store),以便后续查询。我们可以使用 Kafka Streams DSL 来实现这一逻辑,如下所示:
builder.stream(ORDERS.name(), serializer)
       .groupByKey(groupSerializer)
       .reduce((agg, newVal) -> newVal, getStateStore())
第二部分是通过 HTTP 端点将状态存储(state store)暴露出来。这本身很简单,但在多实例运行的情况下,针对特定键(key)的请求必须被路由到正确的分区(partition)和实例上。Kafka Streams 包含一个元数据服务,可以帮你完成这项工作。
通过阻塞式读取来“消除”CQRS 的异步性
订单服务(Orders Service)实现了阻塞式的 HTTP GET 操作,从而确保客户端能够读取到自己刚才写入的数据。这种技术旨在“消除”CQRS 模式固有的异步特性。举个例子:如果客户端在执行写入操作后紧接着进行读取,此时相关的事件可能尚未同步到视图(View)中,这会导致客户端要么收到错误,要么读到不正确的数据。
一种解决方案是让 GET 操作处于阻塞状态,直到相关事件到达(或达到预设的超时时间)。通过这种方式,“消除”了 CQRS 模式的异步性,使得整个过程在客户端看来表现为同步操作。这种技术本质上就是“长轮询”(Long Polling)。在示例代码中,订单服务正是利用非阻塞 I/O(Non-blocking I/O)来实现这一技术的。
在流处理系统中扩展并发操作
库存服务之所以值得关注,是因为它需要采用多种专门技术,以确保其运行的准确性和一致性。该服务执行的操作很简单:当用户购买一台 iPad 时,它会确认是否有足够的库存来满足订单,然后将相应数量的 iPad 锁定(预留),防止其他进程将其占用(图 15-3)。这比初看起来要复杂一些,因为该操作涉及跨多个主题(topic)管理原子状态。具体步骤如下:
- 验证库存中是否有足够的 iPad(仓库总库存减去已预留的库存)。
- 更新“已预留商品”表,锁定该 iPad,确保其他人无法将其占用。
- 发送一条消息,确认订单有效。
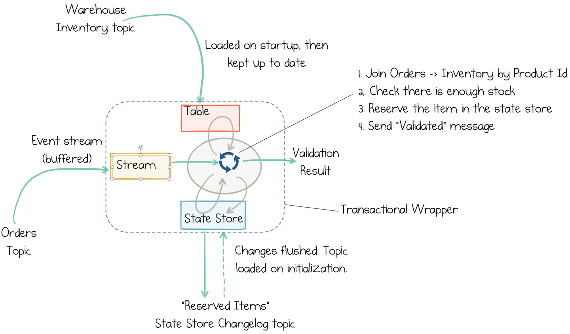
只有满足以下条件,该方案才能可靠地运行:
- 启用 Kafka 的事务功能。
- 确保在执行此操作之前,数据已按
ProductId(产品 ID)进行了分区。
第一点显而易见:如果操作失败且未包含在事务中,我们将无法确定系统会处于何种状态。第二点则稍显复杂,因为要理解其必要性,我们需要考虑将此特定操作通过多个线程或机器进行线性扩展(横向扩展)的情景。
像 Kafka Streams 这类有状态流处理系统,具备一种新颖且高性能的机制,能够并发地处理此类涉及状态的问题。其中包含一个临界区(critical section):
- 读取当前库存中未被预留的 iPad 数量。
- 预留订单所要求数量的 iPad。
我们先来看看传统的(即无状态的)流处理系统是如何运作的(见图 15-4)。如果我们通过两个并行进程来扩展该操作,那么就需要在一个(共享的)数据库中,将上述临界区置于事务内执行。这意味着两个实例都会受限于同一个数据库实例,从而形成瓶颈。
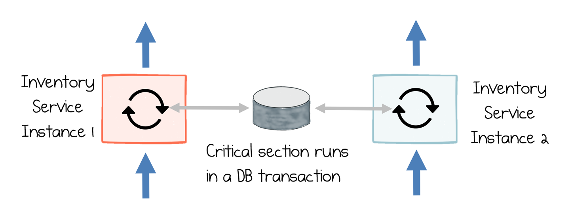
像 Kafka Streams 这样的有状态流处理系统,能够避免远程事务或跨进程协调。其实现方式是:利用选定的业务“键”(key),将处理任务“分区”(partitioning)分配给多个线程或进程。(关于“分区与分区机制”的讨论,请参阅第 4 章。)这正是水平扩展此类系统的“键”(无意双关)所在。
Kafka Streams 中的分区机制通过重新路由消息,确保特定计算所需的所有状态都被发送至同一个线程,从而在该线程内完成计算。3 这种方法天生具备并行性,也是流处理系统能够实现极高单条消息处理速率的原因(例如第 2 章中讨论的用例)。但该方法的前提是必须存在一个逻辑键,能够清晰地隔离各项操作——既包括操作所需的状态,也包括操作所涉及的状态。
因此,通过 ProductId(产品 ID)对任务进行拆分(即分区),可以确保针对同一个 ProductId 的所有操作都在同一个线程上按顺序执行。这意味着所有 iPad 的相关处理都会在同一个线程中完成,而所有 iWatch 的处理则会在另一个(可能是不同的)线程中完成;两者在执行临界区(critical section)逻辑时,无需彼此进行任何协调(见图 15-5)。由此产生的操作是原子的(得益于 Kafka 的事务机制),支持水平扩展,且无需昂贵的跨网络协调。(这与 MapReduce 系统中的 Map 阶段类似。)
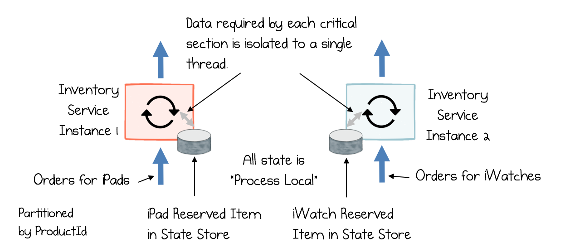
库存服务必须重新组织订单,使其按 ProductId(产品 ID)进行处理。这一过程称为重设键(rekey):将订单推送到 Kafka 中的一个新中间主题(topic),此时以 ProductId 作为键,然后再将其传回库存服务。代码非常简单:
orders.selectKey((id, order) -> order.getProduct())//按 ProductId 重设键临界区的第二部分涉及状态变更:必须预留库存。库存服务通过 Kafka Streams 的“状态存储”(state store)来实现——这是一种基于磁盘的本地哈希表,由 Kafka 主题提供底层支持。因此,每个执行线程都会拥有一个“已预留库存”的状态存储,用于管理部分产品的数据。你可以像操作哈希映射(hash map)或键值存储(key/value store)一样使用这些状态存储,其优势在于所有数据都会持久化到 Kafka 中;如果进程重启,数据还可以恢复。只需一行代码即可创建状态存储:
KeyValueStore<Product, Long> store = context.getStateStore(RESERVED);接下来,我们可以像使用普通哈希表一样对其进行操作:
//获取该产品当前的已预留库存量
Long reserved = store.get(order.getProduct());
//加上当前订单的数量,并将结果存回
store.put(order.getProduct(), reserved + order.getQuantity())
向该存储写入数据也包含在 Kafka 的事务机制中(详见第 12 章)。
通过重设键(Rekey)实现连接(Join)
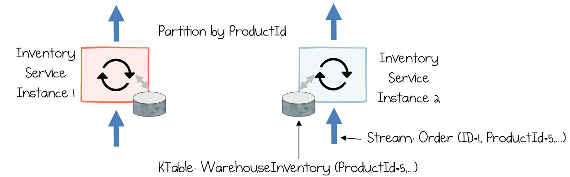
我们可以将上一节中用于“分区写入”的技术,同样应用于“分区读取”(例如执行连接操作)。假设我们需要将一个订单流(以 OrderId 为键)与一个仓库库存表(以 ProductId 为键)进行连接,如图 15-3 所示。该连接操作必须基于 ProductId 进行。
在关系型数据库的术语中,这被称为“外键关系”——即从 WarehouseInventory.ProductId(其主键)映射到 Order.ProductId(非主键)。为了实现这一点,我们需要在不同节点间重新分发(shuffle)订单数据,确保订单最终由负责处理相应仓库库存的同一个线程来处理。
如前所述,这种数据重新分发步骤被称为“重设键”(rekey),而以这种方式组织的数据则被称为“协同分区”(co-partitioned)。一旦完成了重设键操作,即可执行连接逻辑,而无需任何额外的网络访问。例如,在图 15-6 中,productId=5 的库存数据与 productId=5 的订单数据被放置在了一起(即“共址”/collocated)。
重新分区与分阶段执行
在实际应用中,系统往往更为复杂。我们可能在执行连接(join)操作之后,紧接着按客户进行聚合,或者将数据物化到某个视图中;而每种操作都需要不同的数据分布模式。这些不同的操作在流水线(pipeline)中串联在一起。库存服务就是一个很好的例子:它首先通过“重设键”(rekey)操作,将数据按 ProductId 进行分发;随后,为了将数据加入到“订单”(Orders)视图中,又必须再次重设键,将其改回按 OrderId 分布(图 15-7)。(“订单”视图具有覆盖特性——即订单的旧版本会被新版本替换——因此,确保数据流以 OrderId 作为键至关重要,这样才能避免数据丢失。)
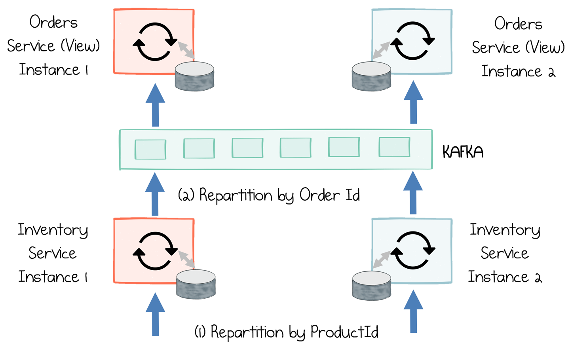
不过,这种方法也存在局限性。若要确保事件流的顺序,用于对事件流进行分区的键(key)必须保持不变。因此,在具体场景中,这意味着与同一订单相关的所有消息,其所使用的键(即 ProductId 和 OrderId)必须始终保持固定。通常,在领域层面实现这一点并不困难(例如,可以规定:如果用户想要更改所购商品,就必须创建一个全新的订单)。
等待 N 个事件
在业务系统中,另一种比较常见的用例是等待 N 个事件发生。如果每个事件都位于不同的主题(Topic)中,处理起来非常简单——本质上就是一个三向连接(three-way join);但如果所有事件都通过同一个主题送达,则需要多花些心思来处理。
在本章前面讨论的示例(图 15-1)中,订单服务需要等待来自三个验证服务的验证结果,而这些结果均通过同一个主题发送。只有当这三个服务全部返回 PASS 时,整体验证才算通过。假设你是根据某个特定的键(Key)来统计消息数量,那么解决方案如下:
- 按键进行分组。
- 统计每个键出现的次数(使用在窗口内执行的聚合器)。
- 过滤输出结果,筛选出达到目标计数值的记录。
关于设计的思考
任何分布式系统都伴随着基础成本,这一点不言而喻。本文所介绍的方案具备良好的可扩展性和韧性,但与实现相同逻辑的简单单进程应用程序相比,其实现与运行的复杂程度必然更高。在进行系统设计时,务必仔细权衡“更优的非功能性特性”与“系统简洁性”之间的取舍。话虽如此,实际系统往往不可避免地会变得更加复杂,涉及更多的组件;因此,这种架构风格所带来的可插拔性和可扩展性,足以抵消其初期投入的成本。
更全面的流处理生态系统
在最后这一节中,我们将简要探讨一个更宏大的生态系统(图 15-8)。该系统整合了本书迄今为止讨论过的一些核心要素,概述了各项服务所发挥的作用,以及它们各自可能采用的实现模式:
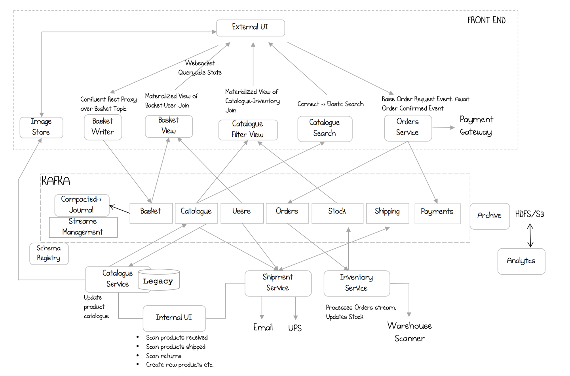
购物车写入器/视图 (Basket writer/view)
这是 CQRS(命令查询职责分离)模式的一种实现,详见第 7 章第 61 页的“命令查询职责分离”一节。当用户添加新商品时,“购物车写入器”(Basket writer)会代理 HTTP 请求,并将其转发至 Kafka 中的“购物车”(Basket)主题。此过程使用了 Confluent REST 代理(随 Kafka 的 Confluent 发行版一同提供)。“购物车视图”(Basket view)是一个基于事件溯源(event-sourced)的视图,由 Kafka Streams 实现;其状态存储(state stores)中的内容通过 REST 接口对外暴露,实现方式类似于本章前面示例中提到的“订单服务”(当然,也可以改用 Kafka Connect 配合数据库来实现)。该视图实际上是“用户”(User)主题与“购物车”(Basket)主题进行连接(join)的结果,但其中大部分信息被舍弃,仅保留了最核心的数据:userId → List[product]。这种做法最大限度地减小了视图的资源占用。
目录过滤视图 (Catalogue Filter view)
这是另一个基于事件溯源的视图。由于它需要更完善的分页支持,因此采用了 Kafka Connect 和 Cassandra 来实现。
目录搜索 (Catalogue search)
这是第三个基于事件溯源的视图;它利用 Solr 实现了全文搜索功能。
订单服务 (Orders service)
订单经过验证后会被保存至 Kafka。该服务既可以作为一个独立的服务实现,也可以构建成一个小型生态系统(类似于本章前面详细介绍的方案)。
目录服务 (Catalog service)
这是一个遗留代码库,用于管理产品目录的变更(变更操作由内部用户界面发起)。该系统用户相对较少,且已有现成的代码库。通过 CDC(变更数据捕获)连接器,系统从原有的 Postgres 数据库中获取变更事件,并将其推送到 Kafka 中。在消息发布之前,会利用“单消息转换”(single-message transforms)功能对消息格式进行调整。商品图片则被保存至分布式文件系统中,供 Web 层访问。
发货服务 (Shipping service)
这是一个基于 Kafka Streams API 构建的流处理服务。它能够响应新订单的创建,并在收到物流公司发来的通知时,更新“发货”(Shipping)主题中的数据。
库存服务 (Inventory service)
这是另一个基于 Kafka Streams API 的流处理服务。它负责在产品入库或出库时,更新库存水平。
归档 (Archive)
所有事件都会被归档至 HDFS,其中包括两个固定的时间点快照(T-1 和 T-10),用于数据恢复。此过程通过 Kafka Connect 及其 HDFS 连接器实现。
流管理 (Streams management)
一组流处理器负责在必要时创建“最新”(latest)/“带版本”(versioned)主题(参见第 4 章第 25 页“长期数据存储”一节中的“最新版本模式”(latest-versioned pattern))。该层还负责管理“切换主题”(swing topics),用于在需要发布不兼容(即破坏向后兼容性)的模式变更时进行过渡。(参见第 13 章第 124 页的“处理模式变更与破坏向后兼容性”一节。)
Schema Registry
Confluent Schema Registry 提供模式及其兼容性的运行时验证。
总结
当我们利用流处理平台构建服务时,有些服务是无状态的——即简单的函数:接收输入,执行业务操作,然后产生输出。有些服务是有状态的,但仅限于读取数据(例如基于事件溯源的视图)。还有一些服务既需要读取也需要写入状态;这既可以在 Kafka 生态系统内部完成(从而受到 Kafka 事务机制的保障),也可以通过调用其他服务或数据库来实现。有状态流处理 API 最具吸引力的特性之一,就是它涵盖了上述所有选项,使我们能够在“无状态方案的运维简便性”与“有状态方案强大的数据处理能力”之间进行权衡取舍。
当然,这种方法也存在弊端。尽管备用副本(standby replicas)、检查点(checkpoints)和压缩主题(compacted topics)等机制能够降低“将数据推送到代码端”所带来的风险,但仍可能出现最坏的情况——即必须重建服务本地的数据集。在进行任何系统设计时,都应将这种可能性纳入考量。
采用流处理模型还需要思维方式的转变。与传统服务接口中偏向过程化的风格相比,流处理模型本质上更具异步性,且更倾向于函数式和以数据为中心的编程范式。但在笔者看来,这种转变是非常值得投入的。
在本章中,我们探讨了一个处理订单的简单系统。我们通过一组小型流处理微服务实现了这一系统,这些微服务应用了我们在第 5 章中讨论过的“事件协作”(Event Collaboration)模式。最后,我们还探讨了如何利用本书中介绍的更多模式,构建出规模更大的架构。
1 在本例中,我们选择使用一个独立的主题(Topic)——“订单验证”(Order Validations);当然,我们也可以采用第 11 章中讨论的“每个转换对应单一写入者”(single-writer-per-transition)模式,直接更新“订单”(Orders)主题。
2 此外,通过 Kafka Connect 将事件溯源(event sourcing)视图实现到你所选的数据库中,也是一种常见的做法——正如我们在第 7 章第 69 页“查询在数据库中创建的‘读优化’视图”一节中所讨论的那样。当你需要更丰富的查询模型或更大的存储容量时,可以采用这种方法。
3 顺便提一下,该功能的一大优势在于它是由 Kafka 本身(而非 Kafka Streams)来管理的。Kafka 的“消费者组协议”(Consumer Group Protocol)允许任何消费者组自行控制分区在组内成员间的分配方式。