第五章 事件:协作的基础
基于服务的架构(如微服务或面向服务的架构 SOA)通常采用同步的“请求-响应”协议构建。这种方式非常直观,毕竟它与我们编写程序时的习惯如出一辙:调用其他代码模块,等待响应,然后再继续执行后续逻辑。它也十分契合我们日常生活中常见的各类场景——例如在网站前端,用户点击按钮后,期望系统能立即完成相应操作并给予反馈。
然而,一旦进入由众多独立服务构成的系统环境,情况便大不相同。随着服务数量的增加,同步交互的网络也随之扩张。原本看似无伤大雅的可用性问题,可能会引发更大范围的系统故障。运维工程师往往被迫化身为“侦探”,在各个服务之间疲于奔命,试图拼凑零散的二手信息,去破解一场场复杂的“分布式谋杀案”(究竟是谁在什么时间对谁说了什么?)。
这是一个广为人知的问题,目前已有多种解决方案。其中一种是确保每个独立服务的服务等级协议(SLA)远高于整个系统的 SLA;Google 就曾提出过一套实现此目标的规范。另一种方案则是打破服务间的同步耦合,引入异步机制,并利用消息代理(Message Broker)作为中间媒介。
以在线零售为例,像 getImage() 或 processOrder() 这类要求立即响应的同步接口,或许让你感到既自然又熟悉。但当用户点击“购买”按钮时,实际上触发的是一个庞大、复杂且异步的处理流程。这一流程涵盖了从下单到最终将商品送达用户手中的全过程,其跨度早已超出了最初点击按钮时的上下文。因此,将软件拆解为异步流程,有助于我们将各类待解决的问题进行隔离,从而更好地适应这个本质上就是异步的世界。
在实际工作中,我们往往会不自觉地采用这类方法。例如,通过轮询数据库表来检测数据变更,或者设置定时任务(cron job)来批量处理更新。这些确实是打破同步耦合的简单手段,但总让人感觉像是某种“临时凑合”的权宜之计。这并非毫无根据——因为它们确实往往就是权宜之计。
因此,我们可以将所有这些问题归纳为一个核心观察:命令式编程模型(即通过指令驱动服务执行任务)并不适用于那些服务各自独立运行的系统环境。
本章我们将探讨架构的另一个侧面:不再通过指令与查询链来组合服务,而是通过事件流来实现。这本身就是一种实现模式,在业界已应用多年;同时,它也构成了我们在第三部分和第五部分所要讨论的更高级模式的基础——在这些模式中,我们将事件驱动处理的理念与流处理平台中的相关思想进行了融合。
命令、事件与查询
在深入探讨之前,我们需要了解程序在网络中进行交互的三种不同方式:命令(Commands)、事件(Events)和查询(Queries)。如果你此前尚未思考过这三者之间的区别,那么现在不妨深入研究一下,因为它们为进程间通信(Interprocess Communication)提供了重要的参考依据。
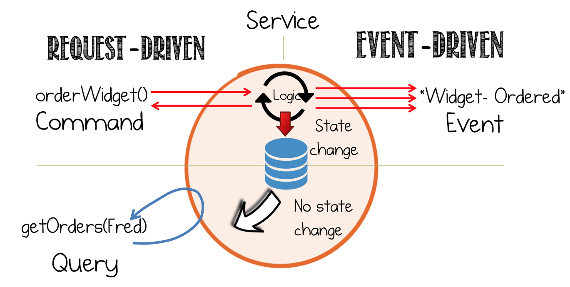
服务间交互的这三种机制可描述如下(参见表 5-1 和图 5-1):
命令 (Commands)
命令即“动作”——即请求另一个服务执行某项操作,且该操作会改变系统的状态。命令以同步方式执行,通常会反馈执行完成的状态,有时也可能包含具体的执行结果。1
- 示例:
processPayment(),返回支付是否成功。 - 适用场景:适用于必须同步完成的操作,或在使用服务编排(Orchestration)/流程管理器(Process Manager)的场景中。建议将命令的使用限制在“限界上下文”(Bounded Context)内部。
事件 (Events)
事件既是“事实”的记录,也是一种“通知”。它们代表现实世界中已经“发生”的事情,且不包含对后续任何行动的预期。事件仅单向传递,无需响应(有时被称为“发送即忘”,即“fire and forget”);不过,响应可以由后续的另一个事件“合成”出来。
- 示例:
OrderCreated{Widget}(订单已创建)、CustomerDetailsUpdated{Customer}(客户详情已更新)。 - 适用场景:适用于需要松耦合的场景(例如多团队协作系统),当事件流可被多个服务所利用,或者需要将数据从一个应用程序复制到另一个应用程序时。此外,事件也非常适合并发执行。
查询 (Queries)
查询即“查找”请求。与事件或命令不同,查询不会产生任何副作用;它们不会改变系统的状态。
- 示例:
getOrder(ID=42) returns Order(42, …)。 - 适用场景:适用于跨服务边界的轻量级数据检索,或服务边界内部的重量级数据检索。
表 5-1。 命令、事件与查询之间的区别
| 行为/状态变更 | 包含响应 | |
|---|---|---|
| 命令 | 请求执行某事 | 可能包含 |
| 事件 | 某事已发生 | 绝不包含 |
| 查询 | 无 | 总是包含 |
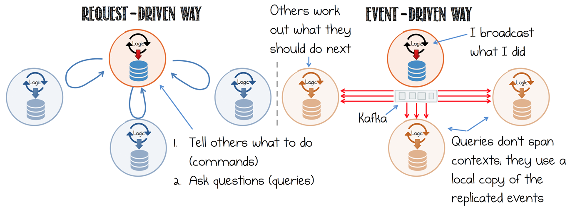
事件的精妙之处在于它戴着两顶“帽子”:一顶是触发服务采取行动的“通知帽”,另一顶是将数据从一个服务复制到另一个服务的“复制帽”。从服务架构的角度来看,与命令和查询相比,使用事件能降低服务间的耦合度。在跨部署边界进行交互时,松耦合是一种理想的特性,因为依赖较少的服务更容易进行变更。
耦合与消息代理
松耦合(loose coupling)这一术语应用广泛。它最初是用于构建程序的一种设计启发式原则;但当应用于网络服务(尤其是由不同团队负责的服务)时,其含义需要做些调整。以下是 Frank Leymann 给出的一个较新的定义:
松耦合是指在双方交换信息时,减少彼此之间所做的假设。
这些假设大致涵盖了数据、功能和运维等多个方面。然而,在实际使用中,人们所说的“松耦合”往往并非上述定义。当人们提到“松耦合”的应用程序时,其含义更接近于“共生性”(connascence),定义如下:2
衡量一个组件的变更对其他组件所产生影响的程度。
这抓住了“耦合”这一概念的直观本质:如果两个实体之间存在耦合,那么对其中一个实体采取的行动,必然会引发对另一个实体的相应影响。在“共生性”的定义中,“变更”(change)一词至关重要,因为它引入了时间维度。耦合并非静态存在;只有当我们试图对软件进行变更时,它才具有实际意义。事实上,如果软件始终保持不变,那么耦合也就根本无关紧要了。
松耦合总是好的吗?
业界普遍存在一种观点,即紧耦合不好,而松耦合好。这种看法并不完全准确。事实上,在不同的场景下,紧耦合和松耦合都有其各自的价值。我们可以这样概括二者的关系:
松耦合使得各个组件能够独立演进;紧耦合则让各个组件能够从彼此身上获取更多价值。
实现松耦合的途径在于“不共享”。如果不进行任何共享,其他应用程序就无法与你产生耦合。例如,微服务架构有时被称为“无共享”(shared nothing)架构 3;它鼓励不同团队之间不要共享数据或功能(跨越服务边界),因为这种共享会阻碍各团队独立运作的能力。4
当然,不共享的问题在于它不利于协作;这往往会导致“重复造轮子”——要么是你自己重复造,要么是迫使别人去重复造。因此,虽然这种做法对你个人而言可能很方便,但对于你所在的部门或公司来说,未必是件好事。不出所料,明智的做法是在两者之间寻求平衡。大多数业务应用程序必须相互共享数据,因此某种程度的耦合在所难免。共享功能(例如 DNS 或支付处理服务)以及共享代码库,往往能带来很大价值。因此,更紧密的耦合完全可能是一件好事,但我们必须意识到,这本质上是一种权衡(tradeoff)。只要我们决定共享某些内容,就必然会增加相应的耦合度。
以传统应用为例,在大多数此类应用中,系统与数据库之间存在紧耦合关系;应用会充分利用数据库处理数据密集型操作的能力,以获取最大价值。这种做法几乎没有弊端,因为应用和数据库通常会同步演进,且你通常也不会允许其他系统直接访问该数据库。另一个例子是 DNS(域名系统),它在整个组织内被广泛使用。这种广泛的使用赋予了它极高的价值,但也意味着它处于“紧耦合”状态。不过,由于 DNS 变更频率极低,且接口非常精简,因此在实际应用中,这种耦合带来的负面影响微乎其微。
由此可见,单个组件的耦合程度实际上取决于以下三个因素,外加一个补充条件:
- 接口的覆盖范围(提供的功能,以及所暴露数据的广度和数量)
- 使用者的数量
- 运行稳定性和性能
补充条件:变更频率——也就是说,如果一个组件(无论是其数据、功能还是运行方式)保持不变,那么耦合(即“共生性”/connascence)也就无关紧要了。
消息传递机制有助于构建松耦合服务,因为它将纯粹的数据从一个高度耦合的位置(源端)转移到了一个松耦合的位置(订阅端)。因此,针对这些数据所需执行的任何操作,并非在源端完成,而是在各个订阅端进行。此外,像 Kafka 这类消息传递技术,还能在很大程度上解决运行稳定性和性能方面的问题。
另一方面,基于请求的交互模式耦合度更高,因为功能、数据和运行要素都集中在同一个地方。本章后续将探讨限界上下文(bounded context)的概念——这是一种平衡上述两种模式的方法:在限界上下文内部使用基于请求的协议,而在限界上下文之间则采用消息传递机制。此外,我们还将在第 8 章详细讨论耦合所带来的更广泛影响。
必要的“数据耦合”不可避免
在规模较大的企业中,总会存在一些众多程序都需要用到的核心数据集。例如,向用户发送电子邮件时需要用到他们的地址;编制销售报告时需要用到销售数据;诸如此类。应用程序离不开数据,而且无法通过代码逻辑来“绕过”对数据的需求(这与通过代码逻辑来规避对某项特定功能的需求是不同的)。因此,在大型组织中,几乎所有的业务系统都需要某种程度的必要数据耦合。
使用事件进行通知
大多数消息代理都提供发布-订阅机制,其中消息路由逻辑由接收方而非发送方定义;这一过程被称为“接收方驱动”的路由。因此,接收方能够掌控自身在交互中的参与情况,从而使系统具备了可插拔性(见图 5-2)。
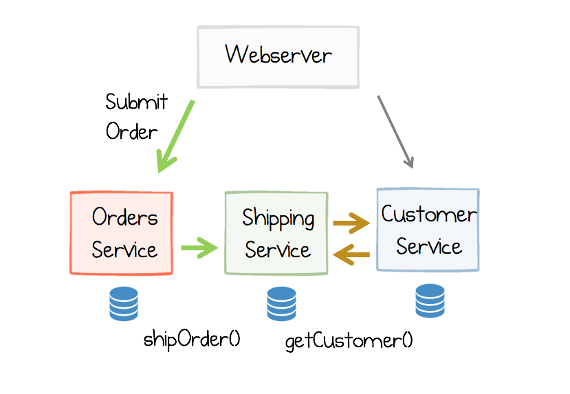
让我们来看一个简单的例子:客户订购了一台 iPad。用户点击“购买”后,系统会向订单服务发送一份订单。随后会发生以下三件事:
- 通知发货服务。
- 查询 iPad 的寄送地址。
- 启动发货流程。
在基于 REST 或 RPC 的架构中,这一过程可能如图 5-3 所示。
同样的流程也可以通过事件驱动的方式(图 5-4)来构建:订单服务只需记录“订单已创建”这一事件,而发货服务则会针对该事件做出响应。
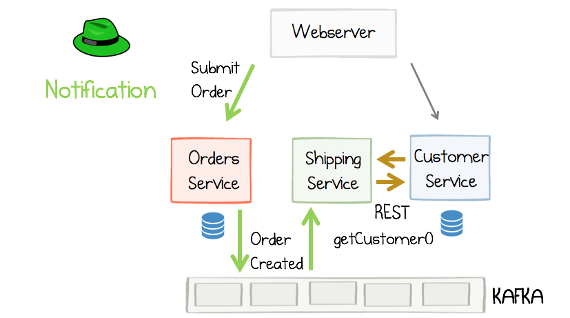
仔细观察图 5-4,可以发现订单服务(orders service)与发货服务(shipping service)之间的交互方式并没有发生太大变化——它们依然在进行交互,只不过现在是通过事件(events)进行通信,而非直接相互调用。但这里有一个重要的变化:订单服务完全不知道发货服务的存在。它仅仅是发布了一个事件,表明自身已完成相关工作,且已创建了一笔订单。现在,发货服务可以自行决定是否参与到这一交互流程中。这就是“接收方驱动的路由”(receiver-driven routing)的一个例子:路由逻辑位于事件的接收方,而非发送方。责任主体发生了反转!这种方式降低了系统耦合度,并为系统引入了极具价值的“可插拔性”(pluggability)。
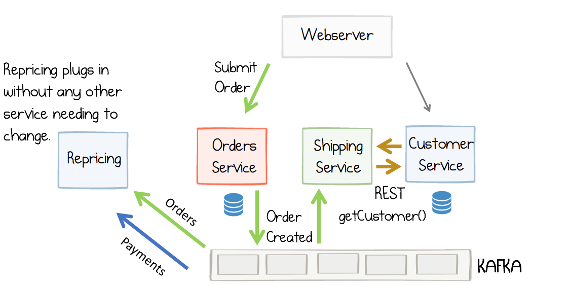
随着系统复杂度的提升,可插拔性变得愈发重要。假设我们要扩展系统,引入一个“重新定价服务”(repricing service)——该服务能够根据供需关系实时调整商品价格(见图 5-5)。若采用基于 REST 或 RPC 的架构,我们需要引入一个 maybeUpdatePrice() 方法,并由订单服务和支付服务分别调用它。而在事件驱动模型中,重新定价服务只需接入订单和支付的事件流即可;当满足特定条件时,它便会自动发布价格更新信息。
利用事件实现状态转移
在图 5-5 中,我们将事件用作通知手段,但针对客户地址的查询仍通过 REST/RPC 调用来完成。
我们也可以将事件用作一种状态转移机制:无需向客户服务(customer service)发送查询请求,而是利用事件流将客户数据从客户服务复制到发货服务(shipping service),从而在发货服务中实现本地查询(见图 5-6)。
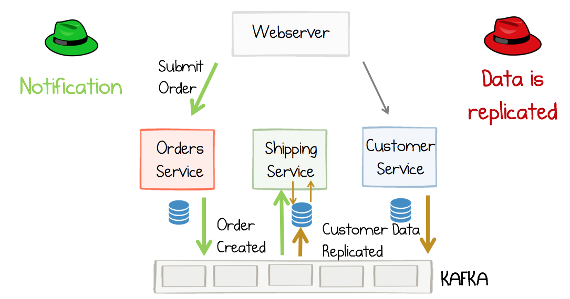
这利用了事件所具备的另一个特性——即其“复制帽”。(在专业术语中,这被称为“事件携带状态转移”,本质上属于数据集成的一种形式。)“通知帽”使架构具备了更强的可插拔性,而“复制帽”则将数据从一个服务转移至另一个服务,从而支持在本地执行查询。在本地复制数据集所带来的优势,与缓存的优势如出一辙——它能有效提升数据访问效率。
该采用哪种方法
我们可以将纯粹的“基于事件携带状态转移(event-carried state transfer)的查询”方法的优势总结如下:
更好的隔离性和自治性
隔离是实现自治的前提。将查询所需的数据保持在隔离的本地状态,意味着这些数据始终处于该服务的掌控之下。
更快的数据访问
访问本地数据通常更快。当需要整合来自不同服务的数据,或者查询跨越地理位置时,这一点尤为明显。
适用于需要离线访问数据的场景
在移动设备、轮船、飞机、火车等场景下,通过复制数据集,可以在重新连接网络时实现数据的转移与重新同步。
另一方面,REST/RPC 方法也有其优势:
简单性
实现起来更简单,因为涉及的组件较少,且无需管理状态。
单例(Singleton)
状态仅存在于一处(不考虑缓存的情况!),这意味着一旦某处的值发生变更,所有用户都能立即看到。这对于需要同步性的用例至关重要——例如,读取更新后的账户余额(我们将在第 15 章第 142 页的“通过阻塞式读取来‘消除’CQRS 的异步性”一节中,探讨如何结合事件来实现这一特性)。
集中式控制
通过“命令与控制(Command-and-Control)”的工作流,可以将业务流程集中在单一的控制服务中,从而使系统逻辑更易于推导和理解。
当然,正如前面所提到的,我们可以将这两种方法结合起来。根据我们侧重的角度不同,可以构建出适用于不同规模架构的解决方案。如果设计的是小型、轻量级的应用(例如构建一个在线应用程序),我们可能会更看重“通知帽”,因为数据复制所带来的开销可能被视为不必要的负担。而在更大、更复杂的架构中,我们则可能更看重“复制帽”,从而让每个服务对其查询的数据拥有更高的自治权。(第 8 章对此有更详细的讨论。)微服务应用往往规模更大,两顶“帽子”都会用到。Jonas Bonér 对此给出了非常明确的论断:
微服务之间的通信必须基于异步消息传递(而每个微服务内部的逻辑则以同步方式执行)。
实现者需要特别注意,他所指的“微服务”是基于严格定义的——即各项服务均可独立部署。而在业界常见的、较为宽松的解读中,未必完全适用这一强断言。
事件协作模式
为了利用事件构建细粒度服务,人们经常采用一种称为“事件协作”(Event Collaboration)的模式。在这种模式下,一组服务围绕同一个业务工作流程进行协作;每个服务通过监听事件来完成各自的任务,并在此过程中产生新的事件。例如,我们可以从“创建订单”开始,随后不同的服务会推动工作流程不断演进,直至所购商品送达用户手中。
这听起来可能与其他工作流程并无二致,但“事件协作”的独特之处在于:没有任何单一服务掌控整个流程;相反,每个服务仅负责其中的一小部分——即状态转换的某个子集——并通过事件链将这些部分串联起来。每个服务在完成自身工作后,会发布一个事件来表明其所执行的操作。例如,如果处理了付款,它会发布“付款已处理”(Payment Processed)事件;如果验证了订单,它会发布“订单已验证”(Order Validated)事件,依此类推。这些事件会触发工作流程中的下一个环节(既可能再次触发当前服务,也可能触发其他服务)。
在图 5-7 中,每个圆圈代表一个事件,圆圈的颜色则标识了它所属的主题。工作流程从“订单请求”(Order Requested)开始,一直演进到“订单完成”(Order Completed)。三个服务(订单服务、支付服务、发货服务)分别负责处理各自职责范围内的工作流程状态转换。关键在于,没有任何服务知晓其他服务的存在,也没有任何服务拥有整个工作流程的控制权。例如,支付服务仅需关注“已验证的订单”并据此发布“付款已处理”事件,而该事件又推动工作流程向前迈进了一步。因此,正如其名,事件协作的核心要素正是——事件!
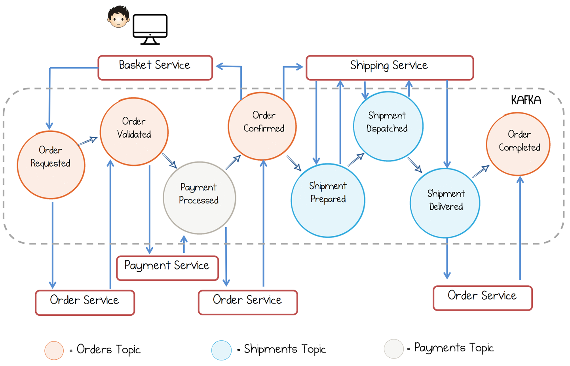
由于缺乏单一的中心控制点,这类系统通常被称为编舞式(choreography)系统:每个服务负责处理状态转换的某个子集,这些子集组合在一起,便构成了完整的业务流程。这与编排(orchestration)形成对比;在编排模式下,由一个单一的流程(例如通过“流程管理器”)从中心位置对整个工作流进行指挥和控制。5 流程管理器是通过“请求-响应”机制来实现的。
编舞式系统的优势在于其具备良好的可插拔性。例如,如果支付服务决定在工作流的支付环节中新增三种事件类型,只要原有的“支付已处理”(Payment Processed)事件保持不变,它就可以自由进行扩展,而无需影响其他任何服务。这意味着在实现某个服务时,你可以调整其内部运作方式,而其他服务无需知晓,也无需关心这些变更。相比之下,在编排式系统中,由单一服务主导整个工作流,因此所有的变更都必须在控制器中进行。究竟哪种方式更适合你,很大程度上取决于具体的使用场景;但编排模式的优点在于,整个工作流以代码形式集中定义在同一个地方,这使得人们更容易理解和分析整个系统。其缺点在于,业务模型与控制器之间存在紧密耦合。因此,从宏观角度来看,编舞式方法通常更适合规模较大的系统实现——尤其是那些涉及多个团队、且各部分需要能够独立演进的系统。
与流处理的关系
事件所体现出的“通知”与“复制”这双重特性,恰好对应了流处理中的“无状态”与“有状态”概念。理解这一点的最佳方式,是回顾本章前面讨论过的“发货服务”示例。如果我们改用 Kafka Streams API 来实现该发货服务,则有两种处理方案(见图 5-8):
有状态方案
将“客户”(Customers)表复制到 Kafka Streams API 中(在图 5-8 中记作“KTable”)。这种方式利用了“事件携带状态转移”(event-carried state transfer)的模式。
无状态方案
在处理每笔订单时,通过事件进行处理,并实时查询对应的客户信息。
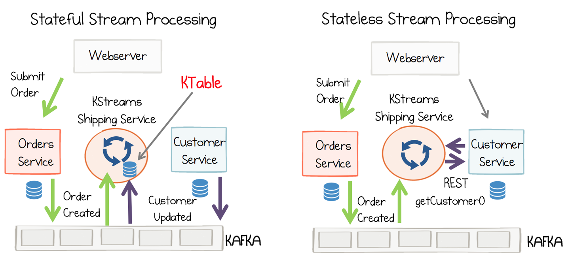
因此,在有状态流处理中,采用“事件携带状态转移”的方式,与本章前面提到的示例相比,主要有以下两点不同:
- 数据集必须完整地保存在 Kafka 中。例如,如果需要与客户表进行连接(join),那么所有的客户记录都必须以事件的形式存储在 Kafka 中。
- 流处理程序内部包含驻留在磁盘上的存储空间,用于保存该表。由于无需依赖外部数据库,这使得该服务具备了“有状态”的特性。Kafka Streams 采用了一系列技术,使得这种有状态特性的管理变得切实可行。
这一主题将在第 6 章中进行详细探讨。
混合使用请求驱动与事件驱动协议
一种常见做法(在小型基于 Web 的系统中尤为多见)是混合使用多种协议,如图 5-9 所示。在线服务直接与用户交互(例如采用 REST 协议),同时将状态变更记录到 Kafka 中(参见第 7 章第 55 页的“事件溯源、命令溯源与 CQRS 概览”一节)。而离线服务(用于计费、订单履行等)则完全基于事件构建。
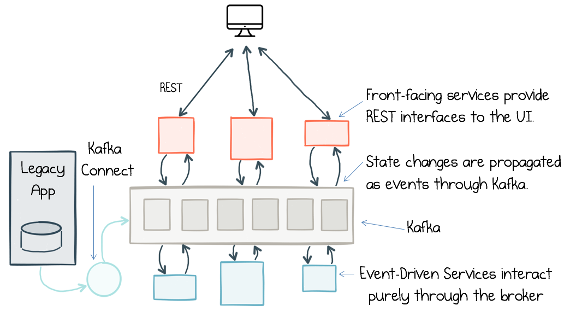
在规模较大的部署中,服务往往会聚集成群,例如按部门或团队进行划分。在同一个服务群内部,服务可能会混合使用多种协议;而服务群之间的通信则依赖于事件(见图 5-10)。
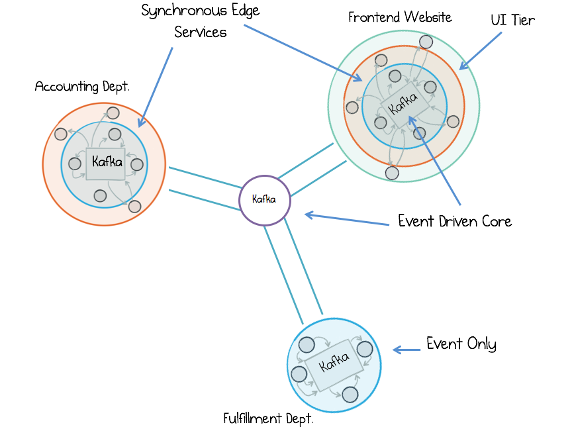
在图 5-10 中,三个部门之间仅通过事件进行交互。在每个部门(即图中的三个大圆圈)内部,服务接口的共享更为自由,且存在更细粒度的、由事件驱动的流程来促进协作。每个部门都包含若干个内部“限界上下文”(bounded context)——即一组共享同一个领域模型、通常一起部署且协作紧密的小型服务集合。在实践中,这种共享往往呈现出层级结构。在这一层级结构的顶端,各部门之间的耦合度较低:它们之间唯一的共享内容就是事件。而在部门内部,则包含多个应用程序;这些应用程序之间既可以通过“请求-响应”机制进行交互,也可以采用基于事件的机制,如图 5-9 所示。每个应用程序本身可能由若干服务构成,但这些服务之间的耦合度通常更高,它们共享同一个领域模型,并拥有同步的发布计划。
这种将复用限制在“限界上下文”之内的做法,源自“领域驱动设计”(Domain-Driven Design,简称 DDD)。DDD 的核心理念之一是:过度广泛的复用反而可能适得其反;更好的做法是围绕业务领域的各个部分划定边界,并分别进行建模。因此,在同一个限界上下文内,领域模型是共享的,各组件之间可以自由交互;而不同的限界上下文之间则不共享同一模型,通常仅通过受限的接口进行交互。
微服务实践者进一步扩展了这一概念:限界上下文在此指代一组紧密相关、共享代码且共同部署的组件或服务。在不同的限界上下文之间,共享的内容(无论是代码、功能还是数据)较少。事实上,正如本章前面所提到的,微服务常被称为“无共享”(shared nothing)架构,原因便在于此。6
总结
企业是由人员、团队和部门构成的集合体,在技术的支撑下执行着各类职能。为了实现高效运作,各团队之间往往需要以异步方式开展协作;事实上,许多业务流程本身就是异步的——例如,将包裹从仓库运送到用户家门口。项目初期可能表现为一个网站,前端通过同步调用与后端服务交互;但随着项目发展,这种同步调用网会使各服务在运行时产生紧密耦合。基于事件的方法则扭转了这一局面,实现了系统在时间维度上的解耦,使各系统能够独立演进。
本章指出,事件实际上具有双重角色:一是作为通知(触发后续行动),二是作为状态转移的机制(将数据推送至所需之处)。事件赋予了系统“可插拔”的特性。对于规模适中的架构而言,结合使用“基于请求”和“基于事件”的协议是明智之举;但务必谨慎对待事件的这种双重性,因为它们会导向截然不同的架构模式。最后,我们探讨了如何通过划分不同的“限界上下文”(Bounded Context)——仅通过事件进行协作——来实现这两种模式的扩展。
尽管通篇都在讨论事件,但我们尚未深入探讨“可重放日志”或“流处理”。当我们结合 Kafka 来应用这些模式时,工具本身便催生了新的可能性。Broker 中的数据保留机制成为了一种可供设计的利器:它让我们能够借助一个供各服务随时回溯的中心化事件存储,拥抱“外部数据”(data on the outside)。因此,本章开头提到的运维工程师们或许仍需扮演“侦探”的角色,但频率有望降低——而且至少现在,他们查案时还有一份“剧本”可循!
1 “命令”(Command)一词最初源自 Bertrand Meyer 提出的 CQS(命令查询分离,Command Query Separation)原则。本文所采用的定义与 Bertrand 的定义略有不同:命令是否需要返回结果,由具体情况而定。之所以这样设定,是因为“命令”本质上是对未来发生特定行为的请求。有时我们不需要返回值,而有时返回值则至关重要。Martin Fowler 曾以“从栈中弹出元素”(popping a stack)为例;本文则以“处理支付”为例——该操作会返回一个结果,用以告知命令是否执行成功。通过允许命令包含可选的返回类型,实现者可以自行决定是否返回结果;若选择不返回结果,则符合 CQS/CQRS 的规范。这种做法避免了为“需要返回结果的命令”另起一个名称。最后,命令绝不等同于事件(Event)。命令包含一种明确的预期,即未来会发生某些事情(如状态变更或产生副作用);而事件则不包含这种对未来的预期,它仅仅是对“某事已经发生”这一事实的陈述。
2 参见 https://en.wikipedia.org/wiki/Connascence 以及 http://wiki.cfcl.com/pub/Projects/Connascence/Resources/p147-page-jones.pdf 。
3 “无共享”(Shared nothing)这一术语在数据库领域也有使用,但其含义略有不同。
4 举个例子:我曾与一个团队合作,他们会对自己发布的部分信息进行加密。这样做并非为了安全,而是为了控制谁能与这些信息产生“耦合”(通过显式地将加密密钥提供给对方)。虽然我不推荐这种做法,但它确实说明了人们确实非常关注这一问题。
5 参见 http://www.enterpriseintegrationpatterns.com/patterns/messaging/ProcessManager.html 以及 https://www.thoughtworks.com/insights/blog/scaling-microservices-event-stream 。
6 Neil Ford、Rebecca Parsons 和 Pat Kua,《构建演进式架构》(加利福尼亚州塞瓦斯托波尔:O’Reilly,2017 年)。