第十一章 事件驱动系统中的一致性和并发性
在我们的行业中,一致性(consistency)一词被过度使用,在不同的语境下有着多种含义。CAP 定理中的“一致性”与 ACID 事务中的“一致性”并不相同;实际上,存在着一系列细微差别的一致性保证,例如强一致性(strong consistency)和最终一致性(eventual consistency)等。关于这一术语缺乏统一的定义,这或许有些讽刺,但它恰恰反映了该主题的复杂性——其复杂程度远超本书的探讨范围。1
尽管存在这些细微差别,大多数人对“一致性”仍有一种直观的理解,这种理解往往源于编写单线程程序 2 或使用数据库的经验。这通常对应于数据库所提供的事务保证:当你写入一条记录时,它会持久保存;当你读取一条记录时,你得到的是最近写入的值;如果你在事务中执行多项操作,这些操作会同时生效(对外界可见),且你无需担心其他用户在同一时间所做的操作。我们可以将这种概念称为直观一致性(在技术术语中,它最接近著名的 ACID 特性)。
在构建业务系统时,一种常见的做法是直接套用这种直观的理解。如果你构建的是传统的三层架构应用(即客户端、服务器和数据库),通常就是这样运作的:数据库负责管理并发变更,确保用户之间的操作相互隔离,从而使所有用户在任一时刻都能看到完全一致的数据视图。然而,在由多个服务组成的系统中,通常无法提供如此强的保证。微服务之间可能会进行同步调用,但随着数据在不同服务间传递,用户往往会在不同时间点看到这些数据——除非所有服务都基于同一个数据库进行协调,并强制采用统一的全局一致性模型。
然而,在分布式应用(跨越不同地理位置、设备等)的环境中,采用单一的全局一致性模型未必总是理想的选择。例如,当你在移动设备上创建数据时,只有在移动设备与后端服务器建立连接的情况下,该数据才能与服务器上的数据保持一致。在断开连接的状态下,系统必然会处于不一致的状态(至少在这一时刻如此);待重新连接后,它们会进行同步,最终达成一致。因此,设计能够妥善处理“不一致期间”的系统至关重要。对于移动设备而言,支持离线操作是一项理想的功能;当设备重新联网时,它能与后端服务器重新同步,从而恢复一致性。不过,这种运行模式的实用价值取决于具体要执行的任务。例如,移动购物应用或许允许用户在离线状态下选购每周所需的杂货,但在用户重新联网之前,应用无法确认这些商品是否有货,也无法真正完成购买流程。由此可见,在某些应用场景下,全局强一致性并非理想选择。
业务系统通常无需以这种方式进行离线操作,但避免全局强一致性和分布式事务依然大有裨益:这类机制不仅难以扩展且成本高昂,在跨地理区域部署时表现不佳,而且往往运行缓慢。事实上,在跨不同系统的分布式事务(如采用 XA 协议)方面的实践经验,促使大多数开发者在系统设计时尽量规避这种高昂的协调机制。
另一方面,业务系统通常又需要强一致性来降低出错风险;因此,也有不少人极力主张采用更强的安全保障机制。此外,还有一种观点认为,应当兼顾两者。事件驱动系统(Event-driven systems)便处于这种折中地带,它们通常采用某种形式的“最终一致性”。
最终一致性
上一节提到了一种直观的一致性概念:即业务操作在单一数据副本上按顺序执行。构建具备这种特性的系统相当简单。各项服务通过远程过程调用(RPC)相互交互,就像单线程程序中的方法调用一样——即一系列顺序执行的操作。数据通过引用(通常使用 ID)进行传递。每项服务根据需要从数据库中查询数据;若需修改数据,则直接在数据库中进行更新。这类系统大致如图 11-1 所示。
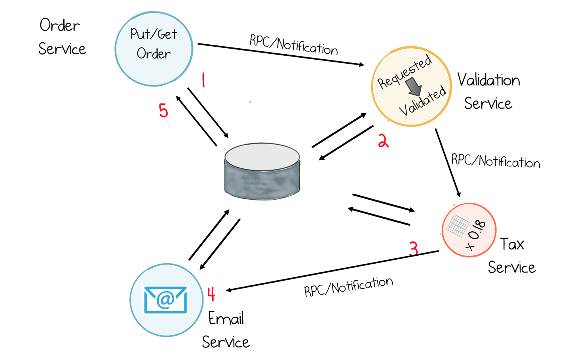
这种方法提供了一种非常直观的模型,因为所有操作都按顺序进行;但随着服务规模的扩大以及新服务的不断加入,采用这种模式的系统在扩展和运维方面会变得愈发困难。
事件驱动系统通常并非以这种方式构建。相反,它们利用异步广播机制,刻意摒弃了对全局状态的依赖,并避免了同步执行。(我们在第 8 章第 80 页的“系统在演进过程中会发生什么?”一节中,探讨过全局共享状态所带来的问题。)这类系统通常被称为具备“最终一致性”。
在此背景下,最终一致性会带来以下两个方面的影响:
及时性
如果两个服务处理同一个事件流,由于处理速率不同,其中一个服务可能会滞后于另一个。如果某项业务操作因故需要同时查询这两个服务,就可能导致数据不一致。
冲突
如果不同的服务针对同一个事件流中的同一实体进行变更,且这些数据后续被合并(例如存入数据库),那么部分变更可能会丢失。
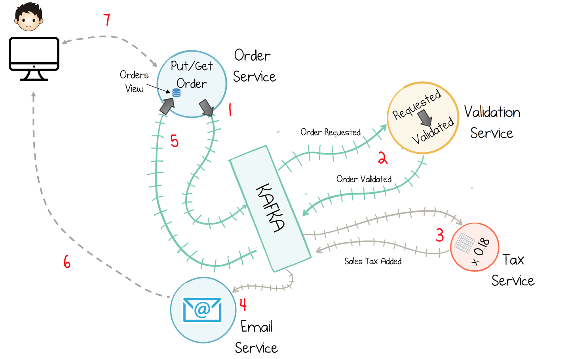
让我们结合在线零售系统这一主题,通过一个示例来深入探讨这些问题。如图 11-2 所示,订单服务接收了一笔订单 (1)。验证服务获取该订单并进行校验 (2)。随后,系统会计算并添加销售税 (3),并发送一封电子邮件 (4)。更新后的订单信息会返回至订单服务 (5),用户可通过“订单视图”进行查询(这是我们在第 7 章中讨论过的 CQRS 模式的一种实现)。在收到确认邮件 (6) 后,用户即可点击链接查看订单详情 (7)。
及时性
以电子邮件服务 (4) 和订单视图 (5) 为例。两者都订阅了同一个事件流(“已验证订单”),并对其进行并发处理。并发执行意味着其中一个处理进度会比另一个稍慢。当然,如果我们停止向系统写入数据,那么订单视图和电子邮件服务最终会达到一致的状态;但在正常运行过程中,它们在事件流中所处的位置会略有不同。因此,它们彼此之间缺乏“及时性”。这可能会给用户带来问题,因为电子邮件服务与订单服务之间存在间接关联。如果用户点击了确认邮件中的链接,但此时订单服务中的视图尚未更新(即存在滞后),那么该链接可能会失效,或者返回错误的状态 (7)。
因此,如果各项服务之间存在某种关联,缺乏及时性(即滞后)就可能引发问题。但在大型生态系统中,实现服务解耦是有益的,因为它允许各服务独立且并发地执行任务;而及时性相关的问题通常是可以妥善处理的(这一点与第 7 章中关于 CQRS 的讨论密切相关)。
那么,如果这种滞后情况(如前述电子邮件示例所示)是不可接受的,该怎么办呢?我们可以重新引入串行执行机制。例如,在调用订单服务时,可以设置阻塞,直到视图完成更新(第 15 章的实践案例中就采用了这种方法)。或者,也可以让订单服务在视图更新后发布一个“视图已更新”(View Updated)事件,以此触发电子邮件服务。这两种方式都能在必要时实现串行执行的效果。
冲突与合并
如果两个服务同时更新同一个实体,就会发生冲突。如果我们采用串行执行的设计,就不会出现这种情况;但如果允许并发执行,冲突则有可能发生。
请参考图 11-2 中的验证服务与税务服务。为了让这些操作按顺序执行,我们可以强制税务服务优先执行(通过将该服务配置为响应“订单请求”事件),随后强制验证服务执行(通过将该服务配置为响应“已添加销售税”事件)。这种方式使每个订单的处理流程线性化,确保最终事件包含了所有必要信息(即既完成了验证,也添加了销售税)。当然,以这种方式强制事件按顺序执行,会增加端到端的延迟。
另一种选择是让验证服务和税务服务并发执行。在这种情况下,我们会得到两个分别包含关键信息的事件:一个是经过验证的订单,另一个是已添加销售税的订单。这意味着,若要获得既经过验证又添加了销售税的完整订单,就必须将这两条消息合并。(因此,在这种方案下,合并操作需要在邮件服务和订单视图中分别实现。)
在某些场景下(例如在线白板工具),允许在不同进程中同时对同一实体进行修改,并在后续进行合并,是非常强大的功能;但在其他场景下,这种做法则容易出错。在构建业务系统时——尤其是涉及资金等敏感领域的系统——我们通常倾向于采取更为谨慎的态度。有一种正式的数据合并技术,能够保证数据的完整性,它被称为“无冲突复制数据类型”(Conflict-free Replicated Data Type,简称 CRDT)。CRDT 的核心在于限制可执行的操作类型,从而确保在数据发生变更并随后合并时,不会丢失任何信息。其局限性在于,所支持的操作(即“方言”)相对有限。
对于大型业务系统而言,一种较好的折中方案是:既保留及时性的缺失(这使我们可以拥有同一状态的多个只读副本),又彻底消除冲突的可能性(通过禁止并发修改)。实现这一目标的方法是:为每种类型的数据(主题)或每个状态转换过程指定唯一的写入者。我们将在下文中详细探讨这一点。
单一写入者原则(Single Writer Principle)
将这些理念进行泛化的一种有效方式,是利用单一写入者原则将一致性问题隔离到特定的“拥有者”服务中。Martin Thompson 提出了这一术语,旨在应对并发环境中锁机制的广泛使用;通过将写入操作集中到单一线程,往往能显著提升系统效率。这一核心思想与 Actor 模型 3、数据库研究中的若干概念 4,以及系统设计实践中的经验之谈都有着密切联系。从服务设计的角度来看,它也与“单一职责原则”不谋而合。
其核心理念非常简单:将传播特定类型事件的职责赋予单一服务——即“单一写入者”。例如,库存服务负责管理库存随时间的变化,订单服务负责管理订单状态的演变,依此类推。
将写入操作集中在单一服务中,能够更高效地管理一致性。然而,这一原则的价值远不止于确保正确性或处理并发问题。例如:
- 它使得版本控制(如分配版本号)和一致性检查(如校验版本号;详见第 108 页的“标识与并发控制”)可以在统一的位置进行处理。
- 它将业务实体随时间演变的逻辑封装在单一服务内,从而更易于理解和变更(例如,在执行模式变更时——详见第 13 章第 124 页的“处理模式变更与破坏向后兼容性”)。
- 它将数据集的所有权明确赋予单一团队,使该团队能够专注于特定领域。在业界实践中,曾出现过一种反模式:在使用企业消息系统(Enterprise Messaging)或企业服务总线(ESB)时,集中化的模式(Schema)和业务逻辑反而可能成为阻碍进展的瓶颈。5 单一写入者原则提倡由服务团队明确拥有共享数据集,既将重心放在“外部数据”上,又为其明确了责任归属。在那些业务规则复杂且涉及多种数据类型的领域中,这一点尤为重要。例如,在金融领域,由于产品需要丰富的领域知识来进行建模和演进,将数据演进的职责集中在单一服务和团队中,通常被视为一种优势。
当“单一写入者”原则与“事件协作”(在第 5 章中讨论)相结合时,每个写入者通过一系列连续的事件,负责演进单一业务流程中的某个环节。如图 11-3 所示(展示了一个规模较大的在线零售业务流程),多个服务围绕订单流程展开协作:订单从创建开始,经过支付处理和发货,最终完成。系统中设有独立的“主题”(topic),分别对应订单、支付和发货;而订单服务、支付服务和发货服务则各自负责管理其对应主题下的所有状态变更。
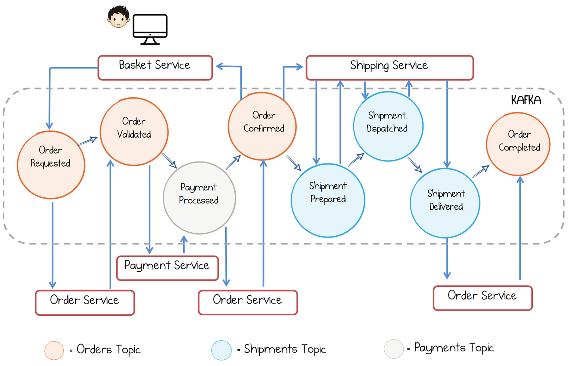
因此,我们不再采用共享全局一致性模型(例如通过数据库实现),而是利用“单一写入者”(single writer)原则来构建局部一致性点,并通过事件流将它们连接起来。该模式有几种变体,我们将在接下来的两节中进行探讨。
正如我们在第 15 章第 142 页的“在流处理系统中扩展并发操作”(Scaling Concurrent Operations in Streaming Systems)一节中所述,如果使用 Kafka 的 Streams API,则可以通过分区(partitioning)手段,实现“单一写入者”的线性扩展。
命令主题
该模式的一种常见变体是为每个实体使用两个主题,通常分别命名为“命令”(Command)和“实体”(Entity)。从逻辑上讲,这与基础模式完全相同;不同之处在于,“命令”主题可由任何进程写入,且仅用于触发初始事件;而“实体”主题则仅允许由拥有该实体的服务(即唯一的写入者)进行写入。通过将两者拆分,管理员能够通过配置主题权限,严格执行“单一写入者”原则。例如,我们可以将订单事件拆分为两个主题,如表 11-1 所示。
表 11-1。“命令主题”(Command Topic)用于将初始命令与后续事件分离开来
| 主题 | OrderCommandTopic | OrdersTopic |
|---|---|---|
| 事件类型 | OrderRequest(ed) | OrderValidated, OrderCompleted |
| 写入者 | 任意服务 | 订单服务(Orders service) |
每个状态转换对应单一写入者
“单一写入者”原则有一种较为宽松的变体:由不同的服务分别负责特定的状态转换,而不是由单一服务负责某个主题(Topic)下的所有状态转换(见表 11-2)。例如,支付服务可能根本不需要使用独立的“支付”主题(Payment Topic),而是直接在现有的“订单”消息中添加支付相关信息(即在“订单”模式/Schema 中包含一个“支付”部分)。在这种情况下,支付服务仅负责这一特定的状态转换,而订单服务则负责其余的状态转换。
表 11-2。订单服务和支付服务均向“订单”主题(Orders Topic)写入数据,但各自负责不同的状态转换
| 服务 | 订单服务 | 支付服务 |
|---|---|---|
| 主题 | OrdersTopic | OrdersTopic |
| 负责的状态转换 | OrderRequested(订单请求)-> OrderValidated(订单已验证)PaymentReceived(已收到付款)-> OrderConfirmed(订单已确认) | OrderValidated(订单已验证)-> PaymentReceived(已收到付款) |
事务与原子性
Kafka 提供了事务功能,包含以下两项保证:
- 在同一个事务中发送到不同主题(Topic)的消息,要么全部写入成功,要么全部不写入。
- 在同一个事务中发送到同一主题的消息,即使发生故障,也不会出现重复。
此外,事务还为 Kafka Streams 提供了一项非常有趣且强大的功能:它能够将对状态存储(State Store)的写入操作与对输出主题的写入操作原子性地绑定在一起。关于 Kafka 事务的详细内容,请参阅第 12 章。
标识与并发控制
在业务系统中,“标识”(Identity)这一概念至关重要,却往往容易被忽视。例如,正如我们在第 12 章中所讨论的,为了检测重复消息,必须能够唯一地标识每一条消息。此外,通过实现“乐观并发控制”(Optimistic Concurrency Control),标识在处理并发更新场景时也发挥着重要作用。
标识的基本原则是:它应当与现实世界中的事物相对应——例如,订单拥有OrderId(订单 ID),支付拥有PaymentId(支付 ID),依此类推。如果某个实体在逻辑上是可变的(例如,订单可能经历Created(已创建)、Validated(已验证) 等多种状态;或者客户的电子邮件地址可能会发生变更),那么该实体还应当具备一个版本标识符:
"Consumer" {
        "CustomerId": "1234"
        "Source": "ConfluentWebPortal"
        "Version": "1"
        ...
}
版本标识符可用于处理并发问题。举个例子(见图 11-4):假设用户 Bob 在一个浏览器窗口中打开了自己的客户详情页面(此时版本为 1),随后又在另一个浏览器窗口中打开了同一个页面(版本同样为 1)。接着,他在第二个窗口中修改了地址并提交了更改,服务器随即将版本号更新为 2。如果此时 Bob 回到第一个窗口并尝试修改电话号码,由于服务器会进行版本比对检查,该更新请求将被拒绝。
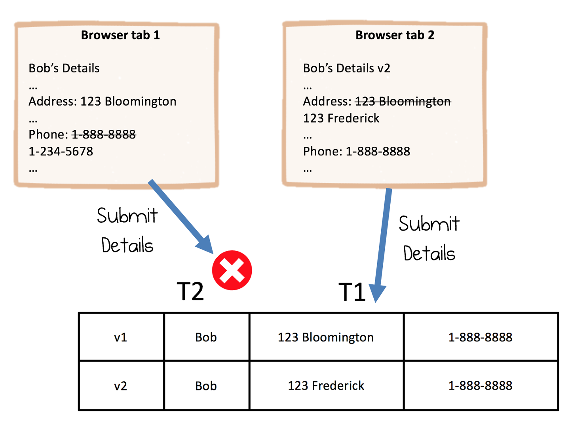
乐观并发控制技术既可在同步系统中实现,也可在异步系统中实现,两者效果相同。
局限性
本章讨论的“单一写入者”原则及其他相关模式,本质上都只是“模式”而已。它们在常见场景下非常有用,但并非放之四海而皆准的通用解决方案。在实际应用中,总会存在例外情况——特别是在实现环境受到诸多限制(例如受限于遗留系统)的场景下。
总结
本章探讨了全局一致性为何会带来问题,以及最终一致性为何具有实用价值。我们将“单一写入者”原则应用于最终一致性模型中,在保留其缺乏及时性这一特征的同时,有效避免了冲突。最后,我们还探讨了如何在事件驱动系统中实现标识(Identity)与并发控制。
1 欲了解详尽论述,请参阅 Martin Kleppmann 所著、内容极其详实的《数据密集型应用系统设计》(Designing Data-Intensive Applications,Sebastopol, CA: O’Reilly, 2017)。
2 各种一致性模型,本质上都是针对“在单一数据副本上按顺序执行”这一概念所做的优化。在实践中,这些优化是必要的;大多数用户更愿意以牺牲一定的保证强度为代价,换取由此带来的更优性能(或可用性)。因此,系统实现者们设计出了多种方式,来放宽“按顺序执行”这一简单保证。这些优化手段衍生出了不同的一致性模型;由于存在多个可优化的维度(特别是在分布式系统中),最终产生了一系列不同的一致性模型。 在第 15 章第 142 页讨论“流处理系统中的并发操作扩展”(Scaling Concurrent Operations in Streaming Systems)时,我们将看到流处理系统如何通过将相关数据划分到不同的流处理线程中,并将这些操作封装在事务内,来实现强一致性保证——即确保针对特定操作,数据在单一副本上是按顺序执行的(即强一致性模型)。
3 https://dspace.mit.edu/handle/1721.1/6952 以及 https://en.wikipedia.org/wiki/Actor_model 。
4 参见 http://bit.ly/deds-end-of-an-era 和 http://bit.ly/deds-volt 。
5 参见 https://thght.works/2IUS1zS 和 https://thght.works/2GdFYMq 。