第十二章 事务,但并非我们所熟知的事务
Kafka 内置了事务功能,这与大多数关系型数据库的做法非常相似。虽然其具体实现方式大相径庭(我们稍后会看到),但目标是一致的:确保即便在发生故障的情况下,程序依然能够产生可预测且可重复的结果。
在服务架构中,事务发挥着三个重要作用:
- 消除重复数据:重复数据往往会导致流处理操作产生错误结果(即便是简单的计数操作也不例外)。
- 支持原子性地向不同主题(Topic)发送一组消息:例如“订单确认”和“扣减库存”这两个操作,如果其中一个成功而另一个失败,系统就会陷入不一致的状态;事务则能确保它们要么同时成功,要么同时失败。
- 结合 Kafka Streams 的状态存储(State Store):由于状态存储底层依托于 Kafka 主题,因此当我们向状态存储保存数据,并同时向另一个服务发送消息时,可以将整个过程纳入同一个事务中。这一特性非常实用。
本章将深入探讨事务机制,分析它所解决的问题、如何正确使用事务,以及其底层的具体实现原理。
重复问题
任何基于服务的架构本质上都是一个分布式系统——而分布式系统领域素以复杂难解著称,尤其是在出现故障时。诸如“二将军问题”(Two Generals’ Problem)之类的思想实验,以及像 FLP 不可能性定理(FLP impossibility result)这样的理论证明,都凸显了这些固有的难题。但在实际应用中,问题似乎并没有那么复杂:如果你调用某个服务时它因故无法响应,只需重试,最终调用总会成功完成。
然而,这种做法会带来一个问题:重试可能导致重复处理,进而引发严重的实际后果。例如,如果从用户的账户中重复扣款,会导致账户余额出错(图 12-1);如果用户的动态信息流中出现了重复的推文,则会严重影响用户体验。诸如此类的例子不胜枚举。
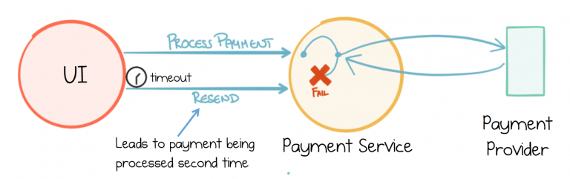
实际上,在我们构建的大多数系统中,这类重复问题都是自动处理的。许多系统只是将数据推送到数据库中,而数据库会根据主键自动进行去重。这种处理流程天然具备“幂等性”。因此,如果客户更新了地址,而我们将该数据存入数据库,那么即便产生了重复数据也无妨——最坏的情况不过是存储客户地址的数据库表被更新了两次,这并不会造成什么严重后果。只要每笔支付都有唯一的标识符(ID),这一逻辑同样适用于支付场景。只要在每个用例的末端执行去重,那么在此过程中产生多少次重复调用也就无关紧要了。这其实是一个由来已久的理念,最早可追溯至 TCP(传输控制协议)诞生之初,被称为“端到端原则”(end-to-end principle)。
问题的关键在于,要实现这种“天然去重”,每一次网络调用都必须满足以下条件:
- 拥有一个能够明确其身份的唯一键(key)。
- 必须在存储了这些键的历史记录的数据库中进行去重。否则,我们就必须在编写业务逻辑时时刻考虑重复数据的可能性,这无疑增加了开发任务的认知负担。
事件驱动系统试图摆脱这种以数据库为中心的处理模式,转而专注于执行业务逻辑、传递处理结果,然后继续后续流程。
结果就是,大多数事件驱动系统不得不在接收到每条消息时先进行去重,然后再进行处理;同时,发出的每一条消息也都必须配备精心设计的 ID,以便下游系统能够据此进行去重。这充其量只是有些麻烦,往坏了说,它简直就是滋生错误的温床。
但仔细想想,处理重复数据的问题,其实和处理消息顺序、安排重发机制,或是 TCP 所提供的其他特性一样,本不该成为应用层需要操心的事情。我们之所以选择 TCP 而非 UDP(用户数据报协议),正是因为我们希望在更高的抽象层面上进行编程,让底层协议帮我们处理数据交付、顺序保证等问题。因此,我们不禁要问:为什么重复数据这类问题,竟然会“渗透”到应用层中来呢?这难道不应该是基础设施层面应该解决的问题吗?
Kafka 中的事务支持构建长服务链,其中链上每一步的处理过程都受到“精确一次”(exactly-once)语义的保障。这减少了重复数据,从而简化了服务的开发;此外,正如本章后续内容所述,在通过 Kafka Streams 状态存储或“事件溯源”(Event Sourcing)设计模式实现数据存储时,事务还能将数据流与状态紧密关联起来。如果使用 Kafka Streams API,这一切都是自动完成的。
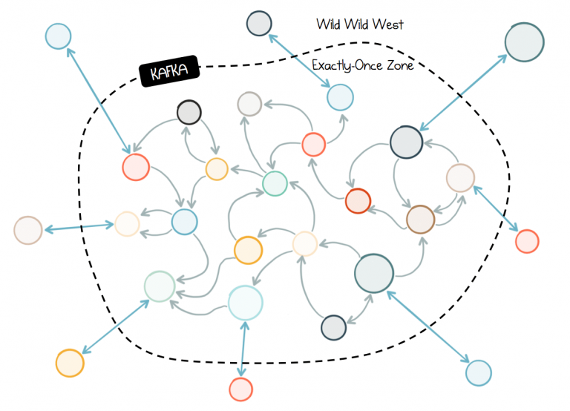
不过,需要指出的是,这并非某种能让整个系统瞬间实现“精确一次”处理的“魔法粉末”。实际系统中往往包含多个不同的组件——有些基于 Kafka,有些则基于其他技术;后者并不在这一保障范围之内。
但对于 Kafka 相关的部分,即各个服务之间的交互而言,它确实能够实现“精确一次”处理(见图 12-2)。这意味着服务无需再自行处理输入数据的去重,也无需费心为输出数据选择合适的键(key)。因此,我们可以在事件驱动的工作流中轻松地将多个服务串联起来,而无需顾虑上述额外问题。这实际上大大减轻了开发者的负担。
使用事务 API 消除重复数据
举个简单的例子,假设我们有一个账户验证服务。该服务接收存款请求,对其进行验证,然后向 Kafka 发送一条新消息,标记该笔存款已通过验证。
Kafka 通过在名为 consumer_offsets 的特殊主题(Topic)中存储偏移量(Offset),来记录每个消费者的处理进度。因此,为了确保每笔存款仅被验证一次,我们需要将最后两个操作——(a) 向 Kafka 发送“存款已验证”消息,以及 (b) 将相应的偏移量提交至 consumer_offsets 主题——合并为一个原子操作(见图 12-3)。实现此逻辑的代码大致如下:
// 读取并验证存款
validatedDeposits = validate(consumer.poll(0))

// 以原子方式发送已验证的存款信息并提交偏移量
producer.beginTransaction()
producer.send(validatedDeposits)
producer.sendOffsetsToTransaction(offsets(consumer))
producer.endTransaction()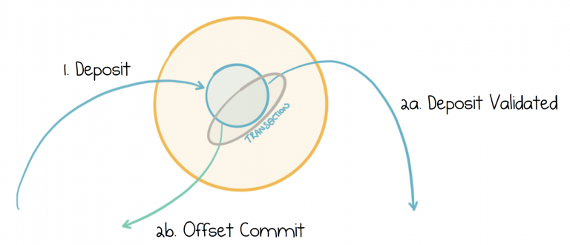
如果你使用的是 Kafka Streams API,则无需编写额外代码,只需启用该功能即可。
“精确一次”(Exactly Once)包含幂等性和原子提交
由于 Kafka 本质上是一个 Broker,因此实际上存在两个可能导致数据重复的环节。向 Kafka 发送消息时,如果确认信息(Acknowledgment)尚未返回给客户端,发送操作就可能已失败;此时若进行重试,便可能导致消息重复。另一方面,从 Kafka 读取数据的进程在提交偏移量(Offset)之前也可能发生故障;这意味着当该进程重启后,同一条消息可能会被再次读取(图 12-4)。
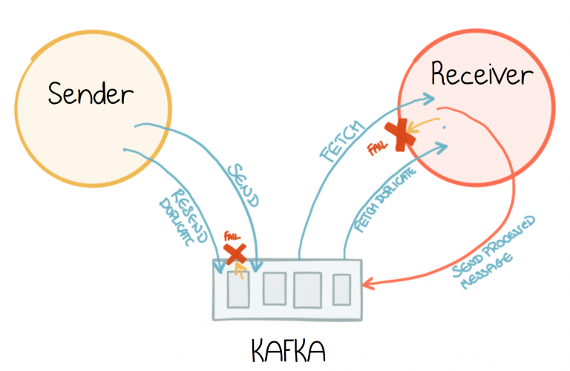
因此,Broker 端需要具备“幂等性”,以确保日志中不会出现重复数据。在此语境下,幂等性本质上就是去重。系统会为每个生产者分配一个标识符,并为每条消息分配一个序列号;两者的组合能够唯一标识每一批发送的消息。Broker 利用这一唯一的序列号来判断某条消息是否已存在于日志中;若已存在,则将其丢弃。与“将所有曾出现过的键(Key)存储在数据库中”的做法相比,这种方式的效率要高得多。
在读取端,我们或许可以通过简单的去重操作(例如在数据库层面)来处理;但 Kafka 的事务机制提供了更广泛的保障——它类似于数据库事务,能够将所有发送的消息关联在一起,实现原子提交(Atomic Commit)。简而言之,Broker 自身内置了幂等性,并在此基础上叠加了原子提交机制。
Kafka 事务的底层运作机制
观察上一节中的代码示例,你可能会发现 Kafka 的事务实现与数据库中的事务非常相似:开启事务,向 Kafka 写入消息,最后提交或中止。但从整体模型来看,两者其实有很大区别——毕竟 Kafka 的事务是专为流处理场景设计的。
一个关键区别在于“标记消息”(marker messages)的使用,这些标记会在各个数据流中进行传递。这一概念最早由 Chandy 和 Lamport 在近 30 年前提出,被称为“快照标记模型”(Snapshot Marker Model)。Kafka 的事务机制正是对这一思想的适配与应用,尽管其具体目标略有不同。
虽然这种事务性消息传递机制在实现上较为复杂,但在概念上却很容易理解(见图 12-5)。以我们之前的例子为例:两条消息被原子性地写入了两个不同的主题(Topic)——其中一条写入 Deposits 主题,另一条写入 committed_offsets 主题。
系统会向这两个主题中分别发送“开始”(Begin)标记。1 随后,我们发送实际的消息。最后,当操作完成后,我们向每个主题发送一个“提交”(Commit)或“中止”(Abort)标记,从而结束该事务。
事务的核心目标是确保下游程序只能看到“已提交”的数据。为了实现这一点,当消费者(Consumer)接收到“开始”标记时,它会启动内部缓冲机制,将后续收到的消息暂存起来。这些消息会一直被缓存,直到“提交”标记到来。只有在收到“提交”标记后,这些消息才会被真正交付给消费程序。通过这种缓冲机制,确保了消费者始终只能读取到已提交的数据。
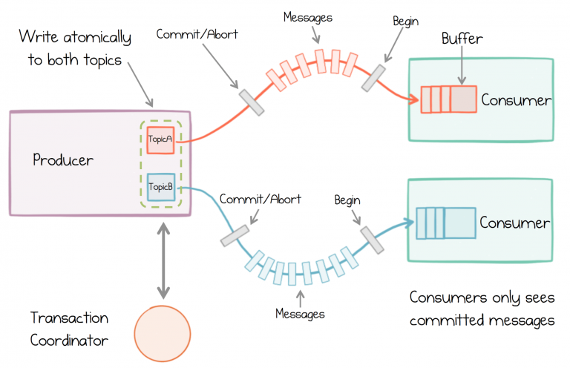
为了确保每笔事务都是原子的,发送“提交标记”(Commit markers)的过程需要借助事务协调器(transaction coordinator)。集群中会分布有多个事务协调器,因此不存在单点故障问题;不过,对于每一笔具体的事务,只会由其中一个协调器负责。
事务协调器充当了最终仲裁者的角色,负责将事务标记为“已提交”(确保原子性),并维护一份事务日志作为支撑(这一步骤实现了“两阶段提交”)。
对于那些担心性能的用户,需要说明的是,该功能确实会带来一定的开销;如果要求每发送一条消息就进行一次提交,性能下降会非常明显。但在实际应用中,完全没必要这样做,因为开销可以分摊到整批消息中,从而在事务开销与最坏情况下的延迟之间取得平衡。例如,若采用每 100 毫秒提交一次批次(消息大小为 1 KB),与“按序、至少一次(at-least-once)”的交付模式相比,其额外开销仅为 3%。你可以使用 Kafka 自带的性能测试脚本自行验证这一点。
实际上,该功能的实现涉及许多微妙的细节,特别是在故障恢复、隔离“僵尸进程”(zombie processes)以及正确分配 ID 等方面。不过,上述内容已足以让你从宏观层面理解该功能的工作原理。若想深入了解事务的具体运作机制,请参阅由 Apurva Mehta 和 Jason Gustafson 撰写的文章《Apache Kafka 中的事务》(Transactions in Apache Kafka)。
原子化地存储状态并发送事件
正如我们在第 7 章中所见,Kafka 可用于在日志中存储数据;其中最常见的方式是 Kafka Streams 中的“状态存储”(state store)——这本质上是一种驻留在磁盘上的哈希表,由 API 内部维护,并以 Kafka 主题(topic)作为持久化支撑。由于状态存储的数据持久性源自 Kafka 主题,我们可以利用事务将“向状态存储写入数据”与“向其他输出主题写入数据”这两个操作绑定在一起。这是一种极其强大的模式,因为它实现了消息系统与数据库之间的原子化绑定——而在传统架构中,要实现这一点,往往需要依赖像 XA 这样极其缓慢的协议。
假设我们对前面的示例进行扩展,让验证服务在处理存款时能够实时追踪账户余额。例如,如果当前余额为 50 美元,此时存入 5 美元,那么余额应更新为 55 美元。在记录“存入 5 美元”这一操作的同时,我们还会将更新后的余额(即 55 美元)写入状态存储(或者直接写入一个压缩主题/compacted topic)中。请参阅图 12-6。
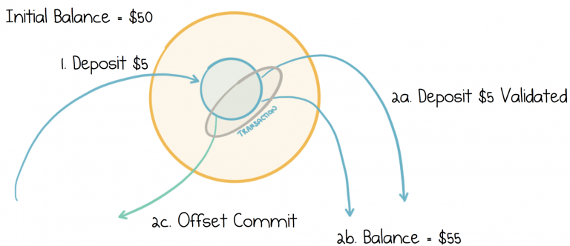
如果启用了 Kafka Streams 的事务功能,所有这些操作都会被自动纳入同一个事务中,从而确保账户余额与存款记录始终保持原子性同步。在使用生产者和消费者时,你也可以通过在代码中手动封装相关调用来实现同样的流程;此外,系统在启动时还可以重新读取当前的账户余额。
这个示例的强大之处在于,它融合了消息传递与状态管理的概念。我们不仅监听事件、执行相应操作并生成新事件,还在 Kafka 中管理着状态(即当前余额)——所有这些过程都被封装在同一个事务之中。
我们需要事务吗?能否仅靠“幂等性”来解决所有问题?
几十年来,人们一直在构建事件驱动和请求驱动的系统,其核心做法就是利用标识符和数据库,确保处理过程具备“幂等性”。然而,实现幂等性并非易事。虽然定义订单的唯一标识符(ID)相对直观,但并非所有事件流都有如此明确的标识概念。例如,若事件流所代表的是“各地区每小时的平均账户余额”,我们虽然也能设法构建出合适的键(key),但这种方案显然更为脆弱,且更容易出错。
此外,事务将“去重”逻辑完全封装在服务内部。即便系统内部产生了重复数据,也不会波及下游的其他服务,从而保持了各服务契约的简洁与独立。反观幂等性方案,它要求下游的每一个服务都必须“正确”地实现去重逻辑;这无疑增加了各服务契约的复杂性,也更容易引发错误。
事务有哪些局限性?
关于事务,有几点局限性或容易产生误解的地方值得注意。首先,事务仅在输入和输出都通过 Kafka 进行处理的情况下才有效。如果你需要调用外部服务(例如通过 HTTP)、更新数据库、向标准输出(stdout)写入内容,或者执行除“向 Kafka Broker 写入数据”及“从 Kafka Broker 读取数据”之外的任何操作,那么事务保证将不再适用,且这些调用可能会被重复执行。因此,就像使用支持事务的数据库一样,Kafka 的事务机制仅在你完全在 Kafka 生态内操作时才生效。
同样类似于访问数据库,当消息发送时,事务即被提交;一旦提交,便无法回滚——即使后续下游的事务处理失败也无法撤销。举例来说,如果用户界面(UI)向“订单服务”发送了一条事务性消息,而“订单服务”在处理过程中(即发送其自身消息时)发生故障,那么“订单服务”所发送的消息会被回滚,但 UI 端发起的事务却无法回滚。如果你需要跨多个服务的事务,可以考虑采用 Saga 模式。
事务在 Broker 端是原子性提交的(就像数据库中的事务提交一样),但系统无法保证消费者具体何时会读取到这些消息。这一点看似显而易见,却有时会引起困惑。假设我们在一个事务中分别向“订单(Orders)”主题和“支付(Payments)”主题发送了消息,我们无法确定消费者何时会读取其中某一条消息,也无法保证消费者一定会同时读取到这两条消息。不过,这与支持事务的数据库所提供的契约完全一致。
最后,本文中的示例使用了生产者(Producer)和消费者(Consumer)API 来演示事务的工作原理。但如果使用 Kafka Streams API,则完全无需编写额外的代码——只需进行简单的配置,即可自动启用“精确一次(exactly-once)”处理机制。
此外,虽然 Kafka 对单个生产者和消费者提供了全面支持,但目前事务机制尚不支持消费者组(Consumer Groups)(不过未来会有所改变)。如果你有这方面的需求,建议使用 Kafka Streams API,它对消费者组提供了全面支持。
在服务中使用事务
在第 5 章中,我们介绍了一种称为“事件协作”(Event Collaboration)的设计模式。在这种模式下,消息在不同服务之间传递,从而构建起一个工作流。该工作流始于“订单请求”(Order Requested)事件,终于“订单完成”(Order Complete)事件。在此过程中,多个不同的服务参与其中,共同推动工作流向前推进。
在诸如此类的复杂工作流中,事务至关重要,因为此时“端到端”原则往往难以适用。若没有事务,每个服务都必须自行执行去重操作。此外,在缺乏事务支持的情况下,构建可靠的流处理应用程序会变得异常困难。原因有二:(a) 流处理应用程序通常会涉及多个中间主题(topic),若在每个处理步骤之后都进行去重,不仅负担沉重,而且在 KSQL 中几乎无法实现;(b) 流处理 DSL 提供了多种“一对多”操作(例如 flatMap()),若没有事务 API,很难确保这些操作具备幂等性。Kafka 的事务功能不仅解决了上述问题,还能将流处理过程与中间状态在状态存储(state store)中的持久化操作原子化地绑定在一起。
总结
事务在多个方面影响了我们构建服务的方式:
- 对于与 Kafka 交互的服务而言,事务消除了对“幂等性”的需求。因此,在构建遵循“读取、处理、(保存)、发送”模式的服务时,我们无需再费心处理输入去重,也无需为输出构建特定的键(key)。
- 我们无需再操心如何为发送的消息确保具备合适的唯一键。虽然对于包含业务事件的主题(topic)而言,这通常不是问题(因为它们往往已有现成的良好键),但在处理衍生数据或中间数据时——例如重映射事件、创建聚合事件,或使用 Streams API 时——这一特性就非常有用。
- 在将 Kafka 用作持久化存储时,我们可以将“发送给其他服务的消息”与“内部所需的状态”封装在同一个事务中,确保它们要么同时提交,要么同时失败。这使得构建简单的有状态应用和服务变得更加容易。
简而言之,在构建基于事件的系统时,Kafka 的事务机制让你无需再为分布式环境下的故障和重试而烦恼——这些本应由基础设施层面来解决的问题,无需再由你的业务代码去处理。这提升了抽象层级,使得在由大量细粒度服务组成的系统中,更容易获得准确且可重复的结果。
当然,我们也应保持谨慎。事务仅解决了分布式系统所带来的诸多挑战之一,还有许多其他问题需要面对。粗粒度服务依然有其存在的价值。但在一个追求快速与敏捷的世界里,流处理平台提升了技术门槛,使我们能够构建出更细粒度的服务;这些服务即便处于复杂的调用链中,其表现也依然像独立运行时那样可预测。
1 在实践中,采用了一种巧妙的优化手段,将缓冲操作从消费者端转移至代理(Broker)端,从而减轻了内存压力。此外,起始标记(Begin markers)也通过优化被移除。